
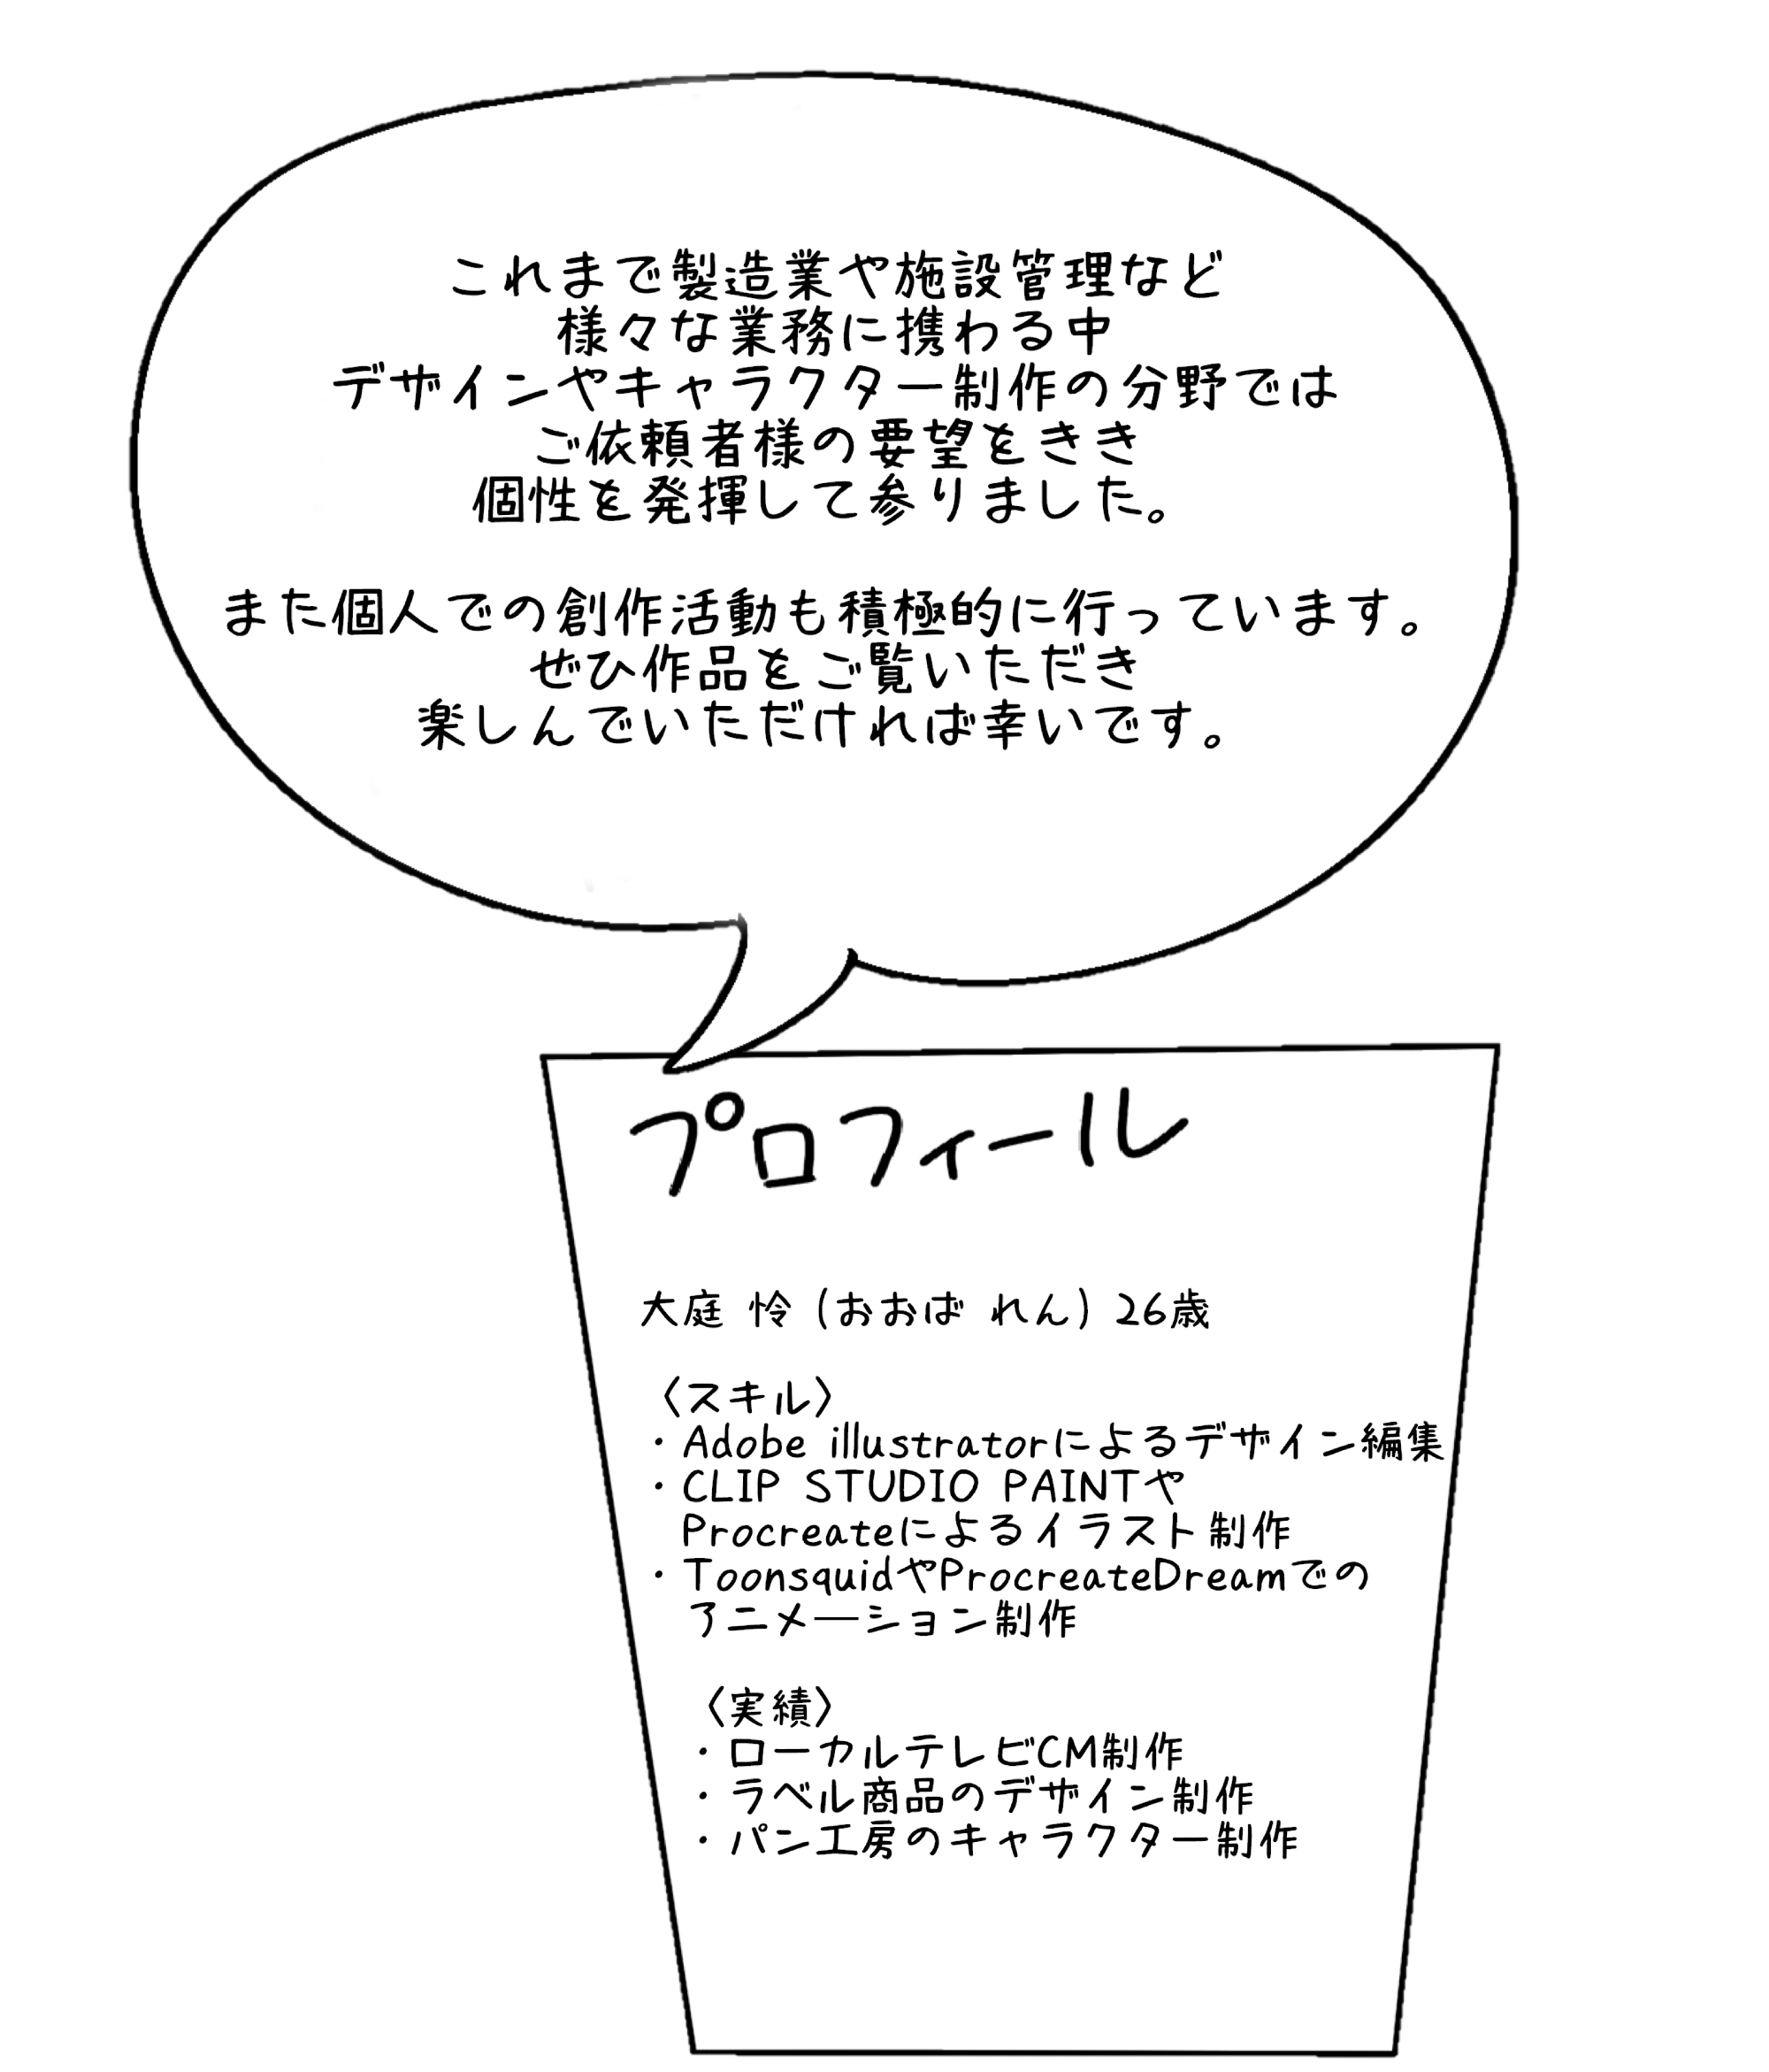
AI技術の発展を取り入れ、新しい技術と創作に
日夜取り組んでおります。
使用するツールとしては、Stable Diffusion ForgeやComfyUI
を活用しており、追加学習の調節を行っております。
加えて、CLIP STUDIO PAINTやAdobe Illustratorも駆使して
より多彩な表現や細部の調整を行い、作品の完成度を高めています。
これらのツールを組み合わせて、視覚的な工夫を凝らした
作品づくりを行っています。
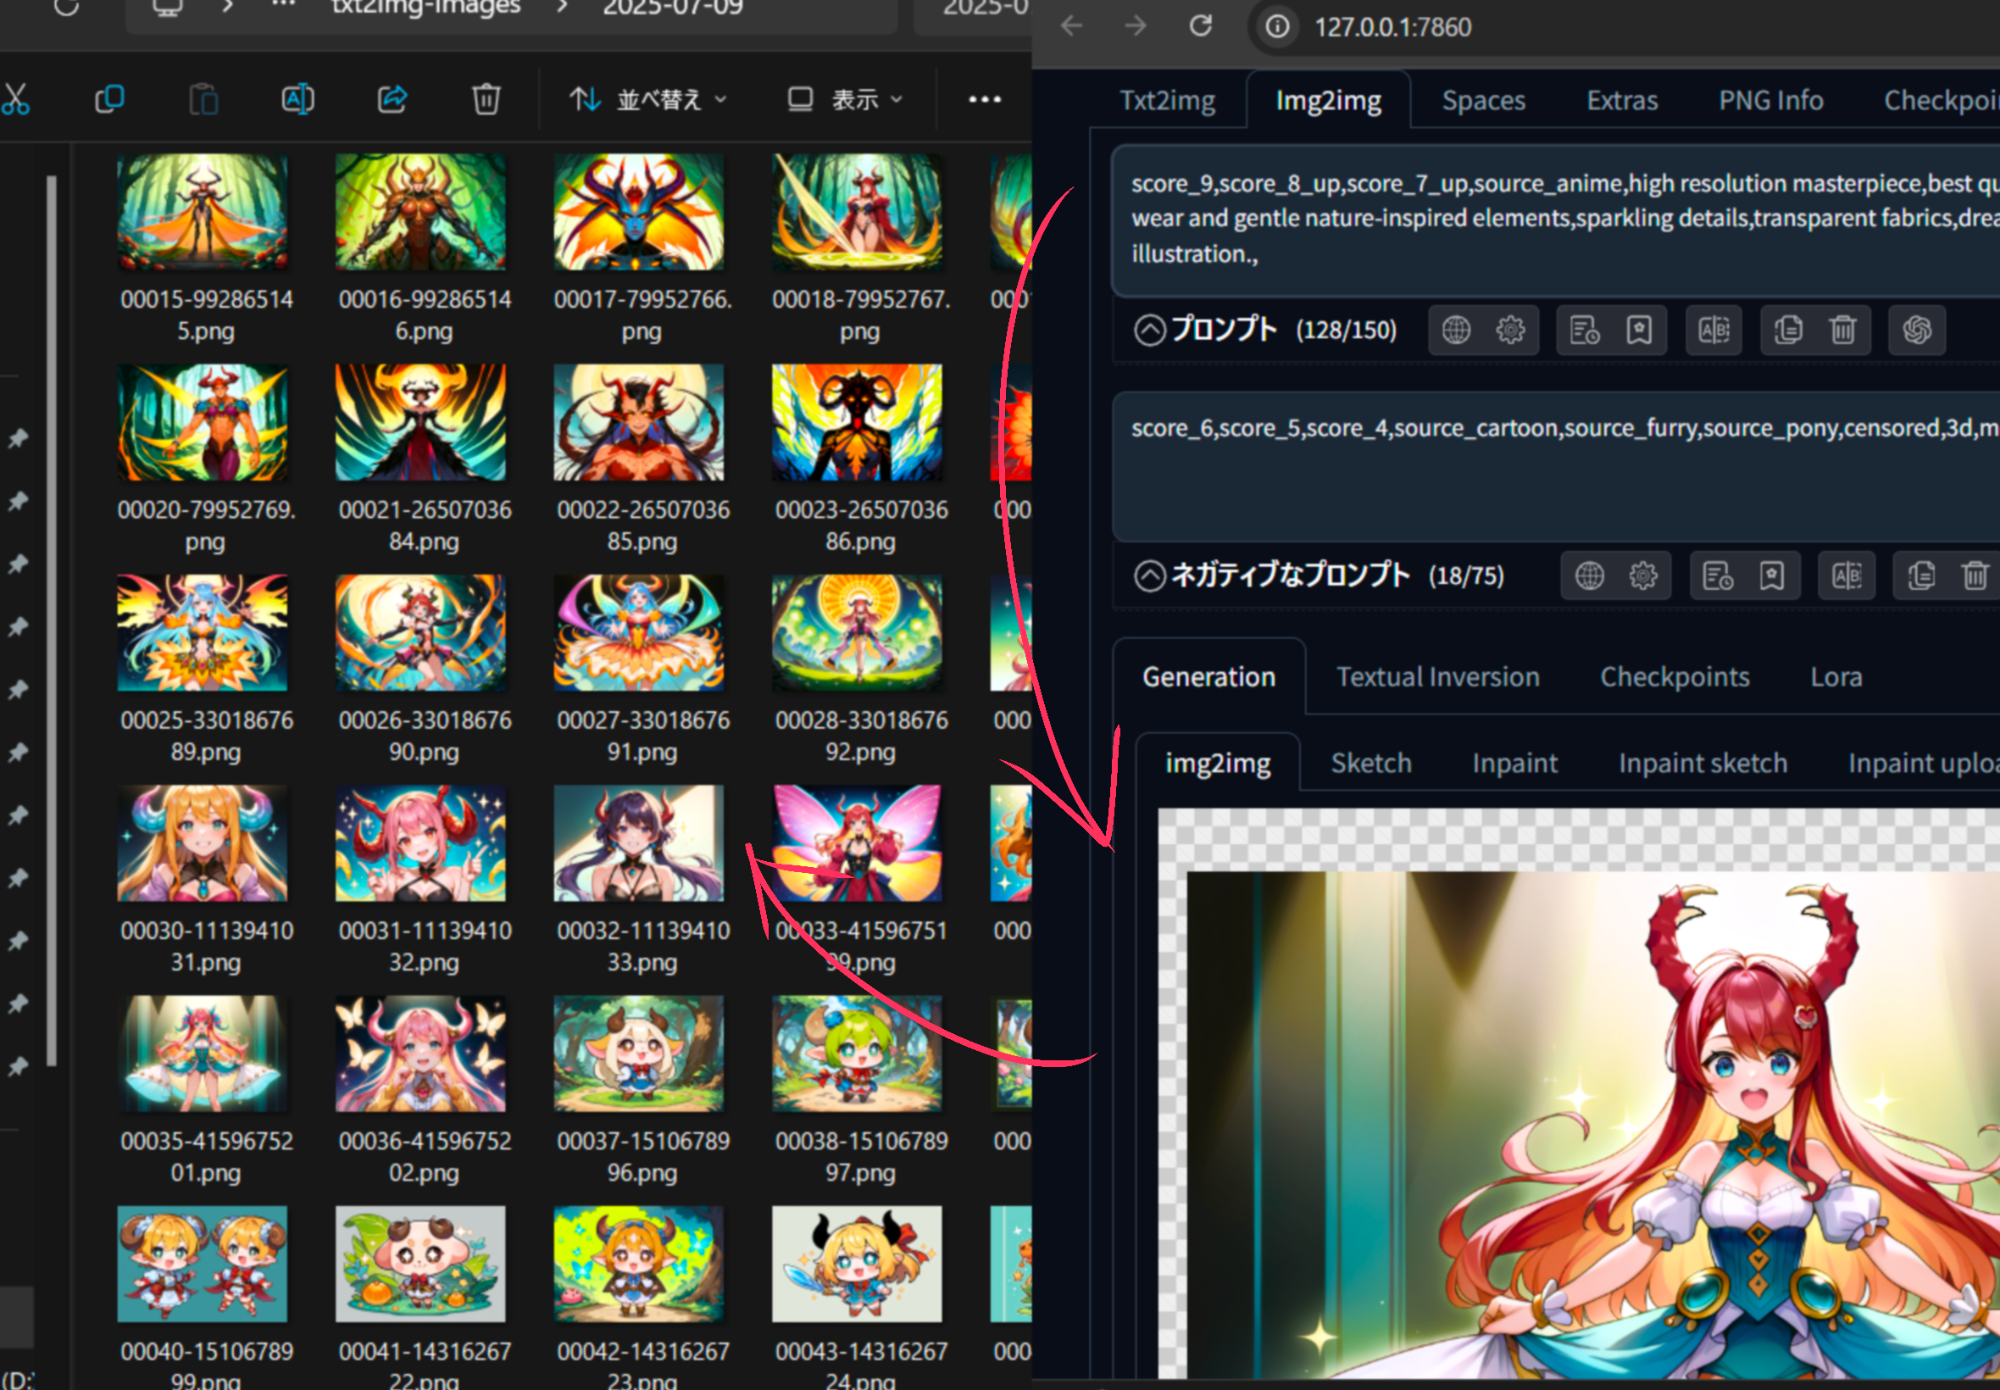
Stable Diffusionのオープンソース技術を基盤に、Automatic1111を使用したローカル環境構築からAI画像生成の道をスタートさせました。
現在はStable Diffusion Forgeを活用し、モデルの細かなチューニングを重ねながら高品質な画像生成に取り組んでいます。
特に力を入れているのはモデルの特性を活かした創作です。
SD1.5は実写モデルのContorolNetの最終調節用としていますが、イラストの中ではSDXL系モデルであるPony系統モデルを使用しています。Pony系統のモデルでは躍動感ある構図と豊かな表情、表現が可能だ考えています。
Illustriousモデルも視野にいれつつ、Ponyモデルを主軸に、キャラクターの生命力や感情を引き出す生成を追求中です。
技術の進化と表現の可能性を日々探求しながら、AIならではの創造性を形にしています。
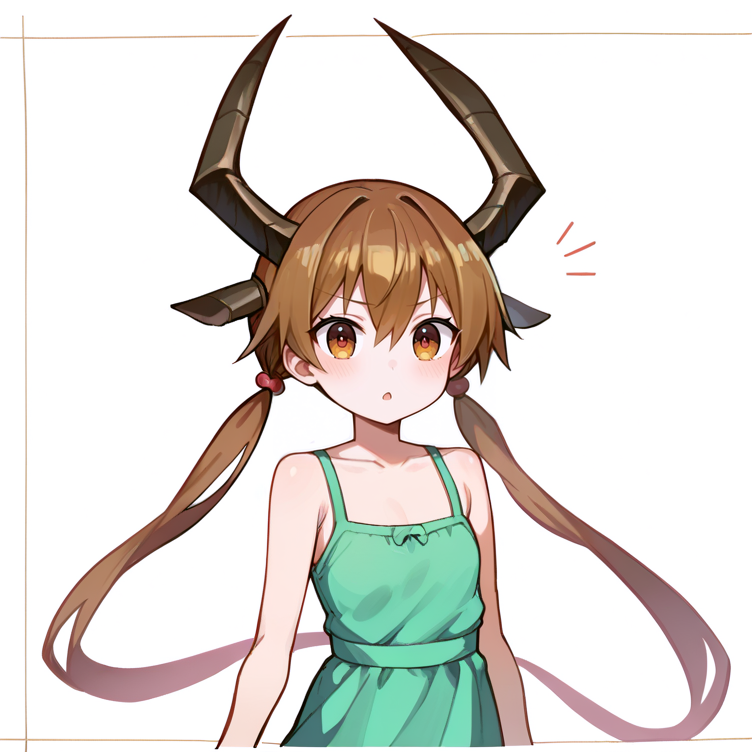
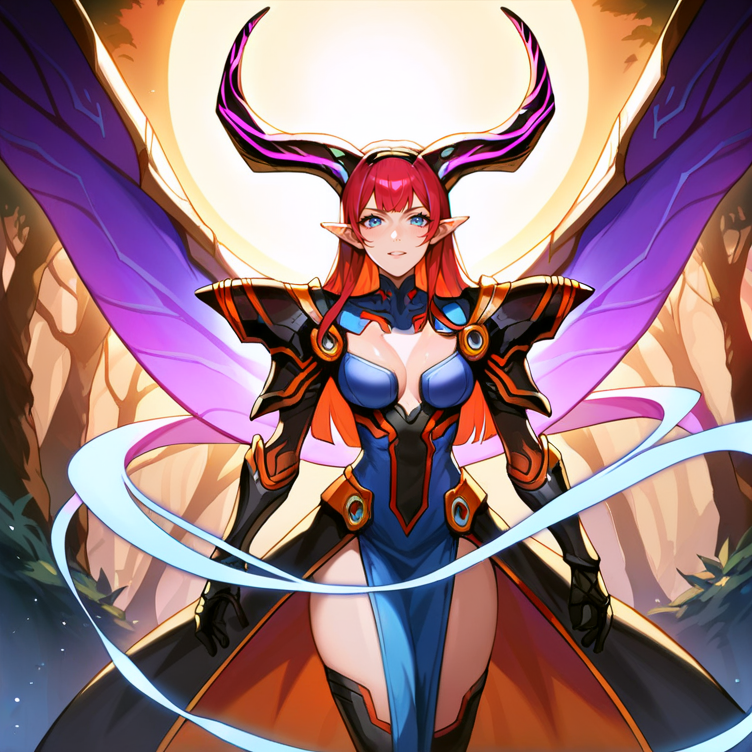
発想の段階としての、簡易的な絵を作成します。(手描き)
Stable Diffusion Forgeのimg2imgを使用し、表現してほしい内容が現段階で生成可能かをみます。
グラフィックCGのような絵にするために、プロンプト指定を考えていきます。
より細かい描写ですが、想定よりも等身が高く、スタイリッシュな見た目となっています。近年のソーシャルゲームにちかい見た目にするために、そこからさらにプロンプトの内容に変更を加えていきます。
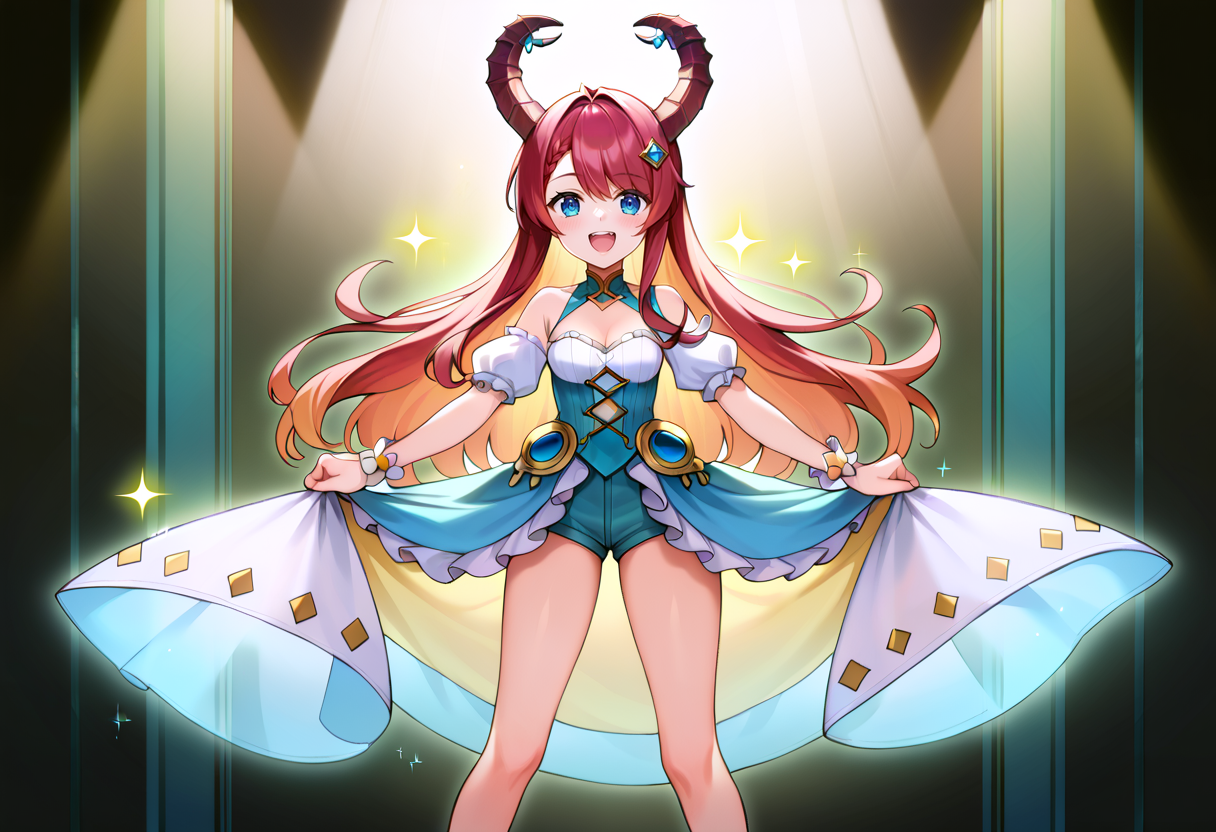
より想定に近い形の絵を生成を目指し、左の図の形となりました。
この時点での絵の内部データは以下のようになっています。
Steps: 30 Sampler: Euler a Schedule type: Automatic CFG scale: 10
Seed: 1322427520 Size: 1216x832
プロンプト:score_9,score_8_up,score_7_up,source_anime,high resolution masterpiece,best quality BREAK Kawaii game character art,stag beetle horns,dressed in a delightful mix of futuristic idol wear and gentle nature-inspired elements,sparkling details,transparent fabrics,dreamy atmosphere,innocent smile,dynamic and cute pose,soft lighting,crisp lines,official game illustration.,
ネガティヴプロンプト:score_6,score_5,score_4,source_cartoon,source_furry,source_pony,censored,3d,monochrome,blurry,lowres,watermark,logo,bad anatomy,bad proportions,NEGATIVE_HANDS,
ADetailerプロンプト: "score_9,score_8_up,score_7_up,source_anime,high resolution masterpiece,best quality,detailed face,
ADetailerネガティヴプロンプト: "score_6,score_5,score_4,source_cartoon,source_furry,source_pony,censored,3d,monochrome,blurry,lowres,watermark,logo,bad anatomy,bad proportions,deformed face,ugly,bad face,deformed eyes,deformed mouth,lipstick",
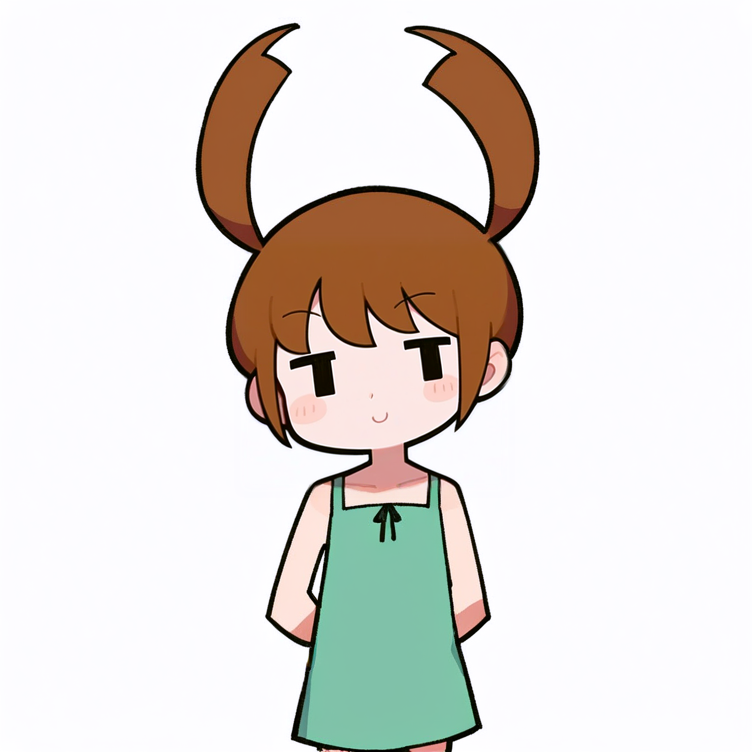
昆虫の茶色と、森にいるような緑のドレスのキャラクターとなっています。
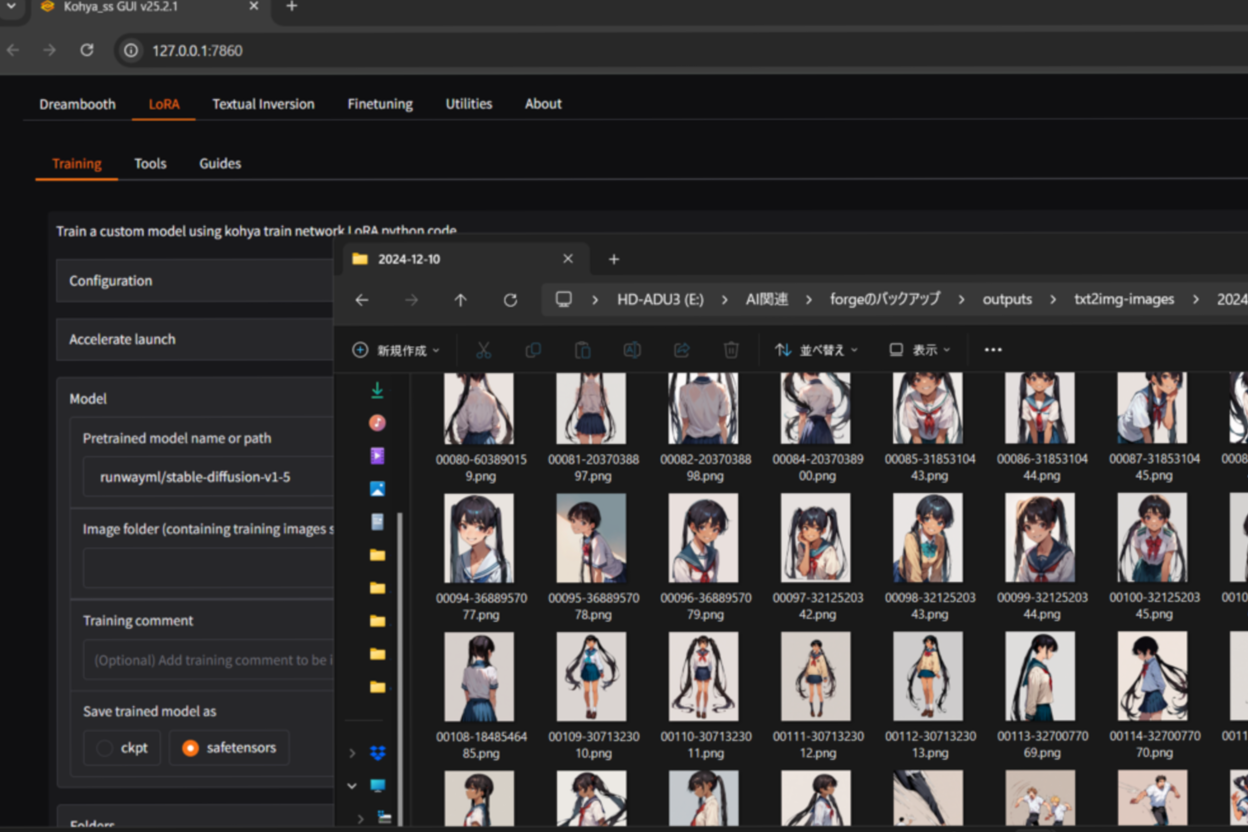
Stable Diffusionでは、複数のモデルを組み合わせるモデルマージでベースの画風を決めますが、LoRA(Low-Rank Adaptation)による追加学習がより効果的だと考えています。
特にキャラクター生成においてLoRAは、少ないデータ量で高精度な学習が可能かつ、学習時間やGPUコストを抑えつつ品質を維持できます。
効率的なLoRA学習の工夫として、パラメータ調整を通じて、画像枚数と学習時間の最適化を実現しています。
ステップ数(Steps)では過学習を防ぐため、2000ステップを目安にしています。
DimとAlphaでは、Dim(次元数)を低い値でキャラクターの本質的な特徴を抽出し、ノイズを軽減させています。Alpha(スケーリング係数)ではDimとの比率を調整し、学習の強度を制御しています。大抵のLoRA作成の場合、Dimを60前後、Alphaを15から必要に応じて30手前にしています。
データセットの選別として、10から50枚の画像で十分な結果を得られるよう、姿勢や表情のバリエーションを作成したのち、学習に使用しています。
これらの調整により、限られたリソースで再現性の高いLoRAモデルを構築し、キャラクターの一貫性を保ちながら効率的な学習を実現しています。
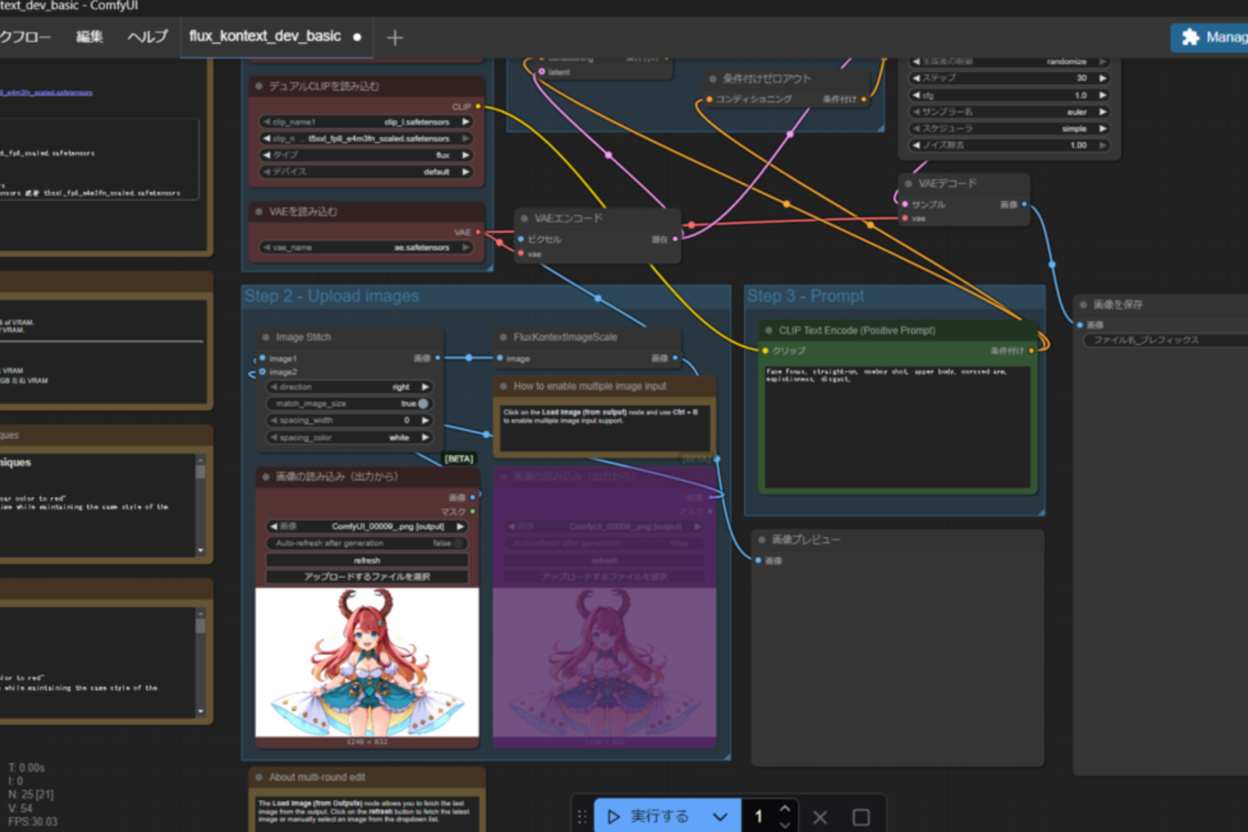
最近では、ComfyUI上でFlux_Kontextを活用した追加学習の研究を行っています。この手法は、LoRAを使用せずにテキストプロンプトだけで、絵柄やキャラクターの特徴を維持したまま、多様なアクションやシチュエーションを生成を可能とします。
プロンプトの指示だけによる短時間で、キャラクターのポーズ変更(例:横を向く・走る・マイクを持つ)に対応し、従来のLoRA学習よりも迅速です。
リソース効率として、学習時間やデータ収集のコストを大幅に削減できます。
今後の展開として、ComfyUIでFlux_KontextのAPIを取得し、LoRA作成の補助ツール化とすることや、そのままの差分生成として活用する方法を考えています。
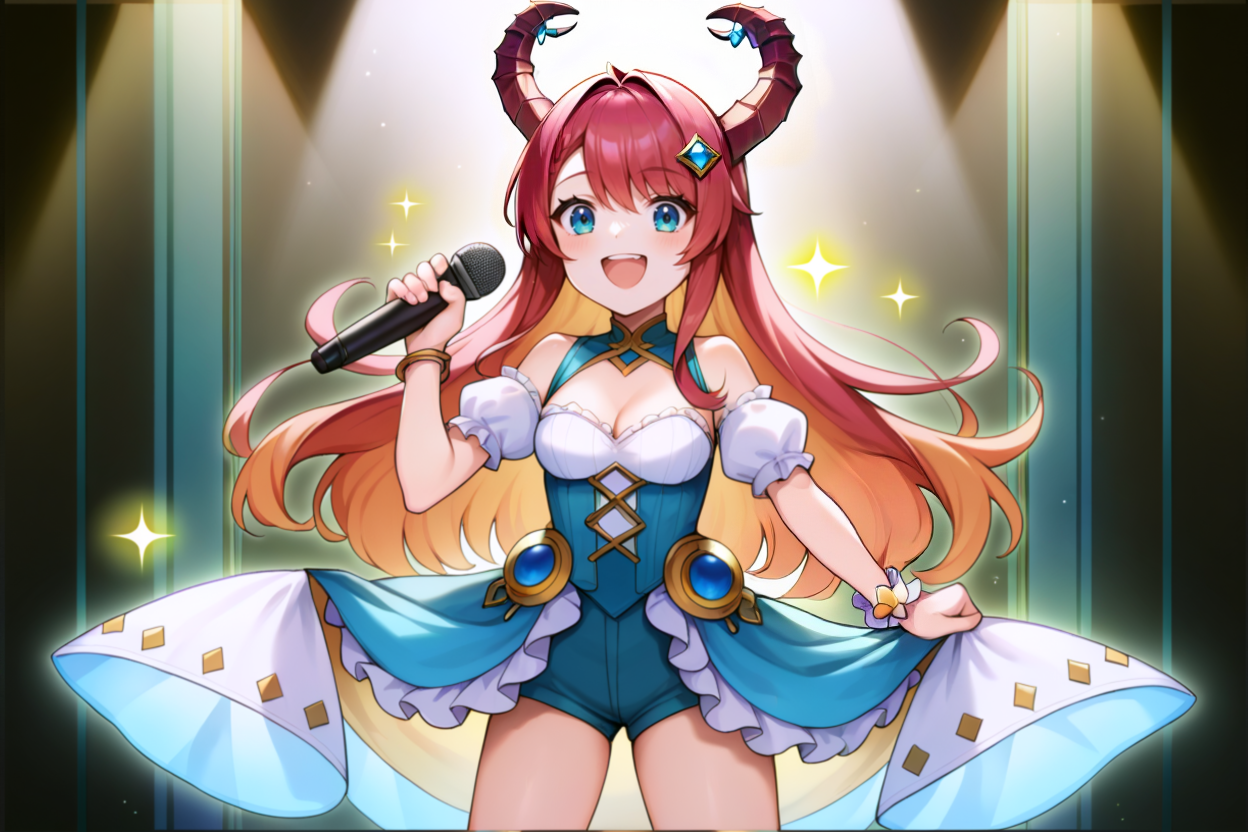
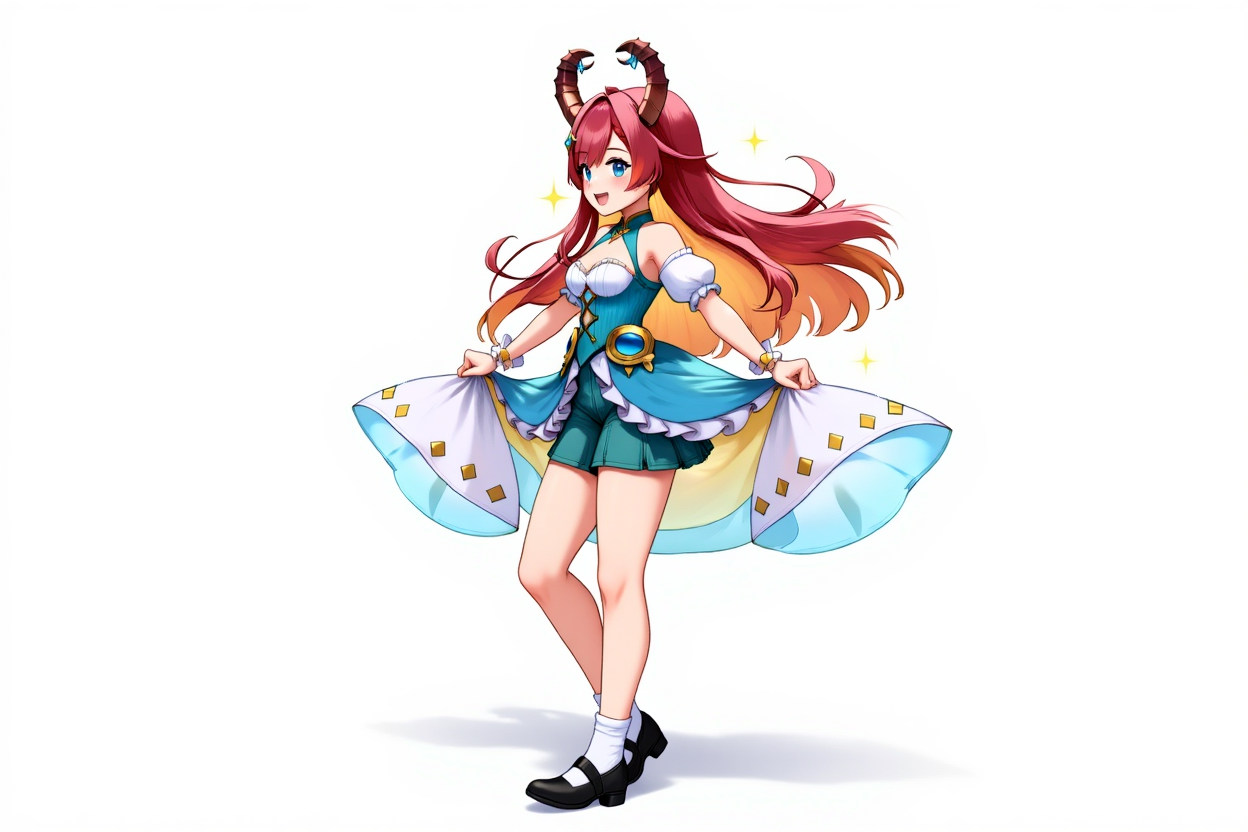
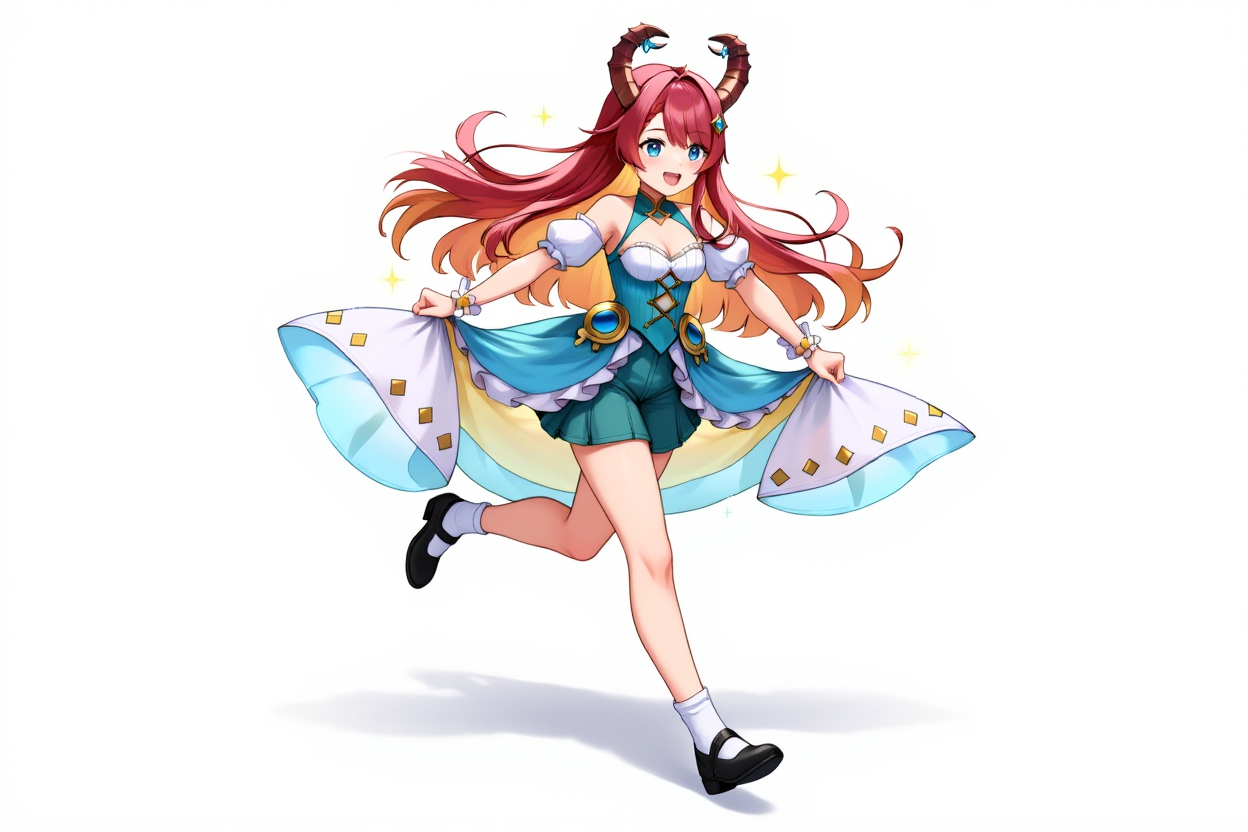
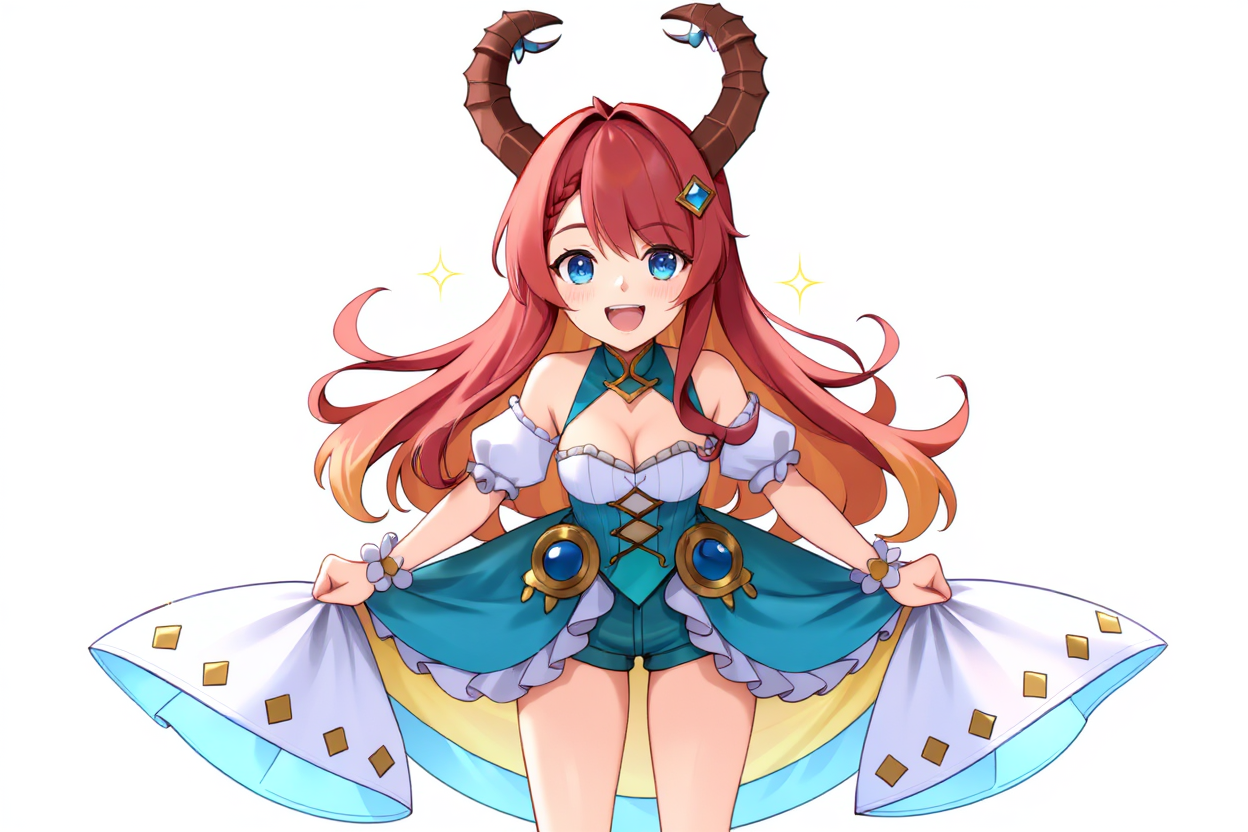
Flux_Kontextで生成した画像となります。画風やキャラクターを崩すことのない差分作成として活用が見込めます。
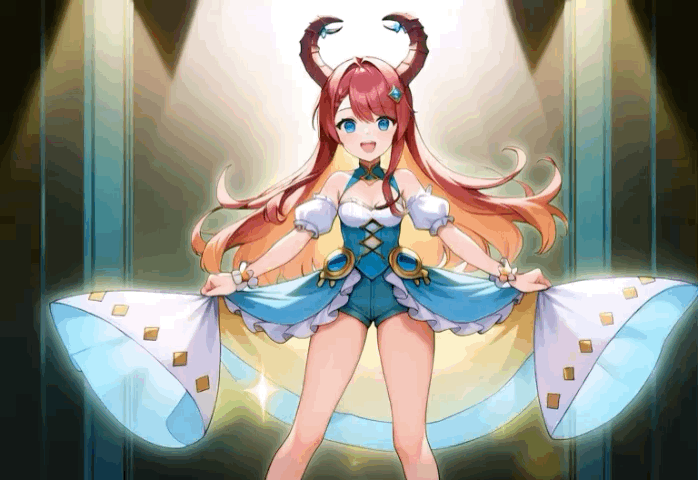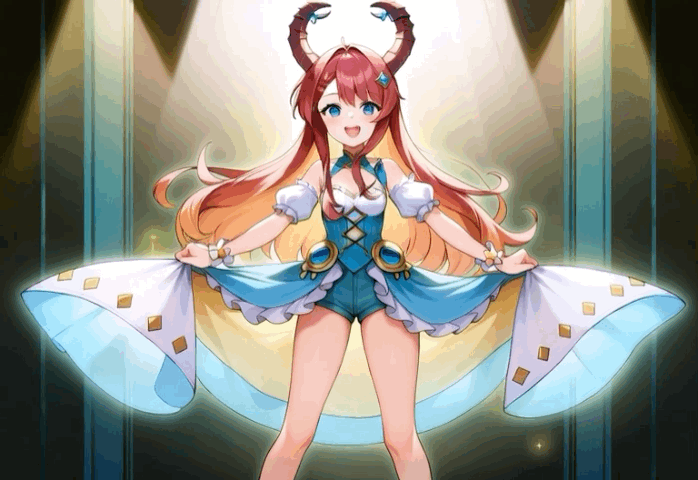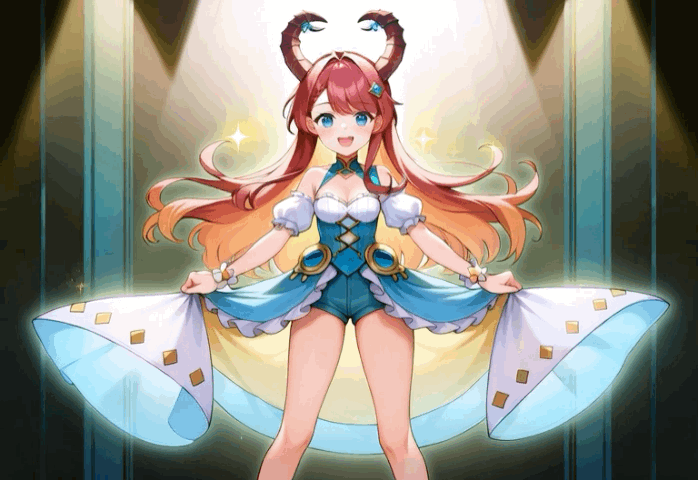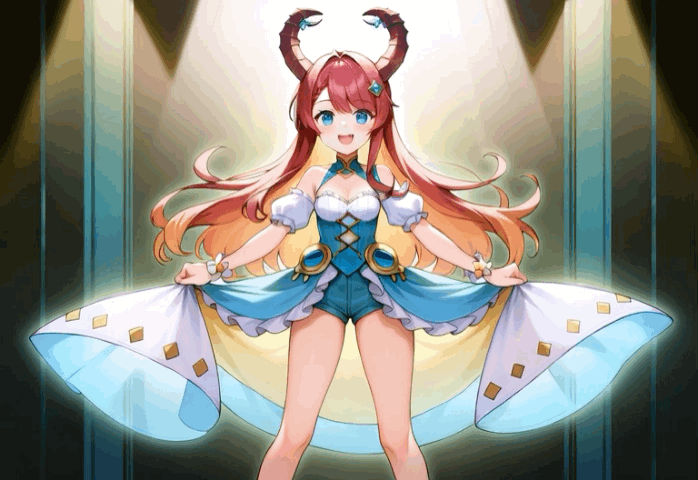
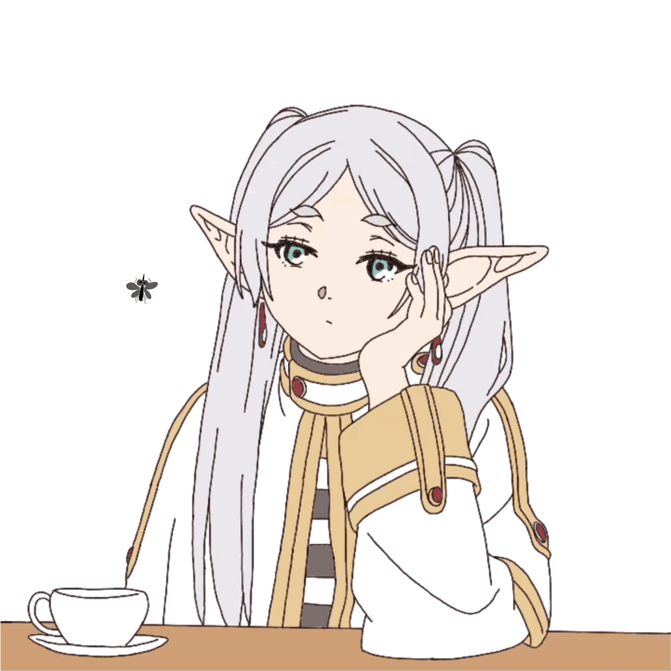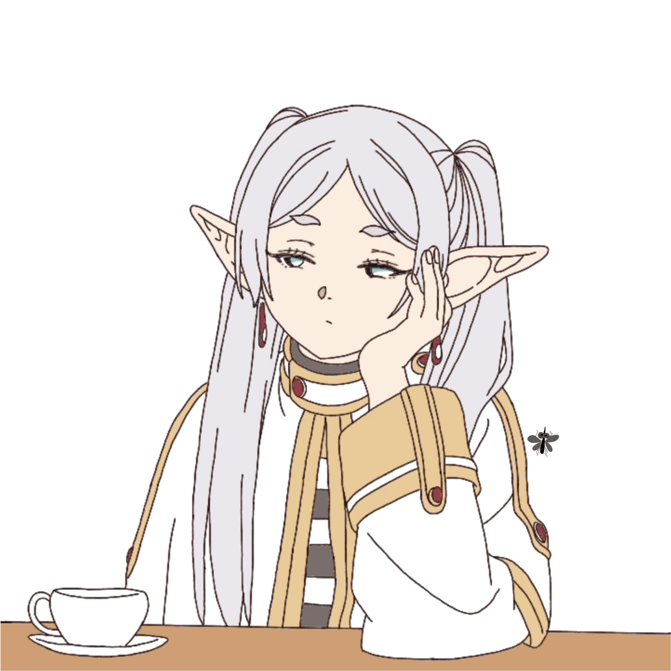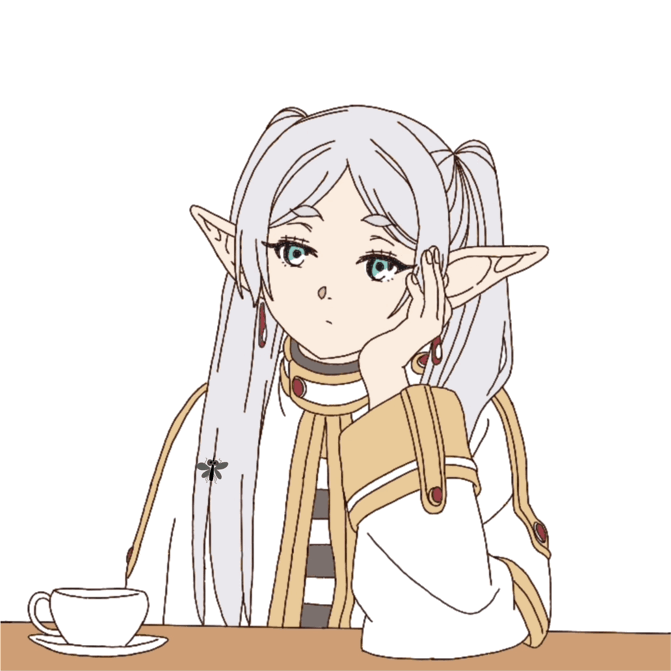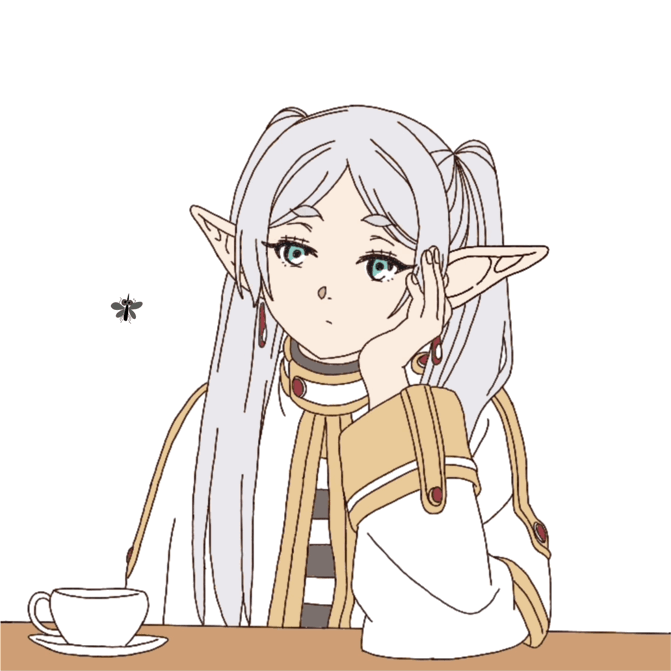
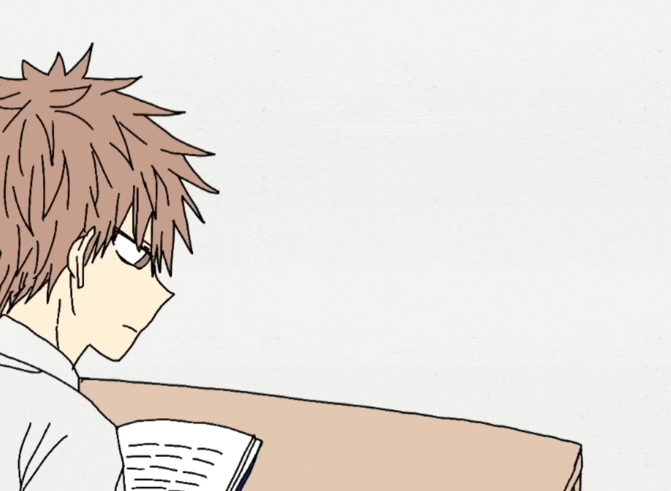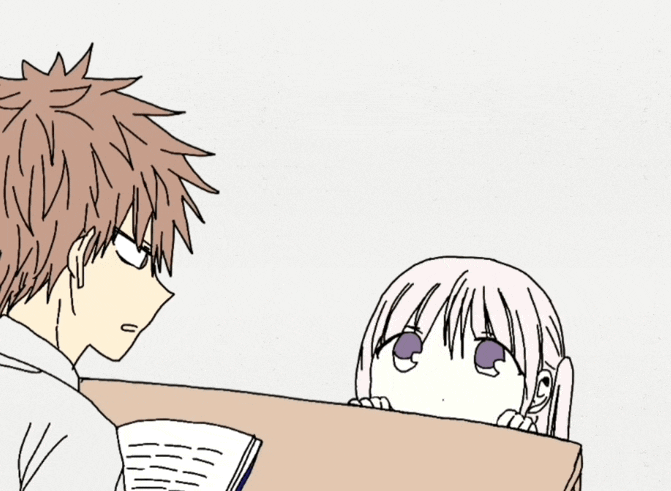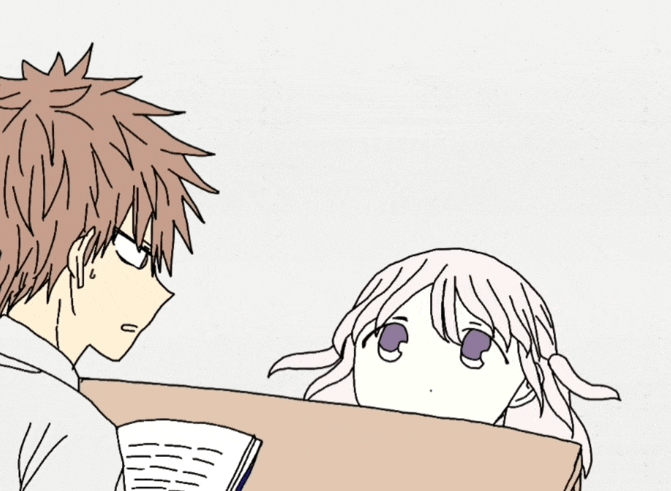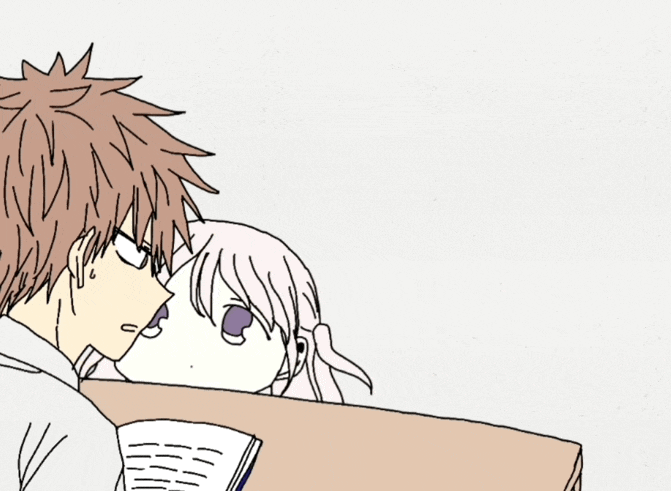
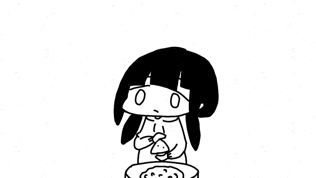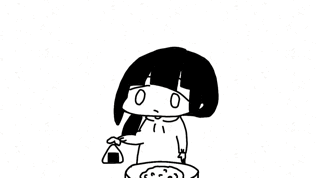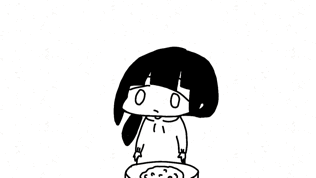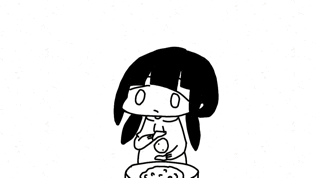
※こちらはgifになります。動画形式では、より背景が鮮明になっております。
Wan2.1 を用いたAI動画生成にも取り組んでおります。
ローカル環境下で効率的な動画生成を実現するため、生成時のステップ数は15程度に抑え、Tea Cacheの値を必要に応じて1.75に設定するなどの最適化を行っております。Live 2Dのような自然な動きをAIで再現できる点を強みとしており、キャラクターアニメーションや表現豊かな動画コンテンツ制作のツールとして活用しています。
AI技術の進化が目覚ましい中、の可能性を最大限に引き出し、作品の質と制作工程の削減に重きを置いて活動しています。これまでに、FANZAやDLsiteにてイラスト本やCG集を出版し、デジタルコンテンツ制作の実績を積んでまいりました。
AIを活用した制作においては、常にAIの持つ独特な画風を活かすか、あるいは手描きの温かい雰囲気を出すかを、作品のテーマや目指す表現に応じて試行錯誤しています。AIの高速な生成能力と、手描きで培った表現力を組み合わせることで、新たなアートの可能性を追求しています。
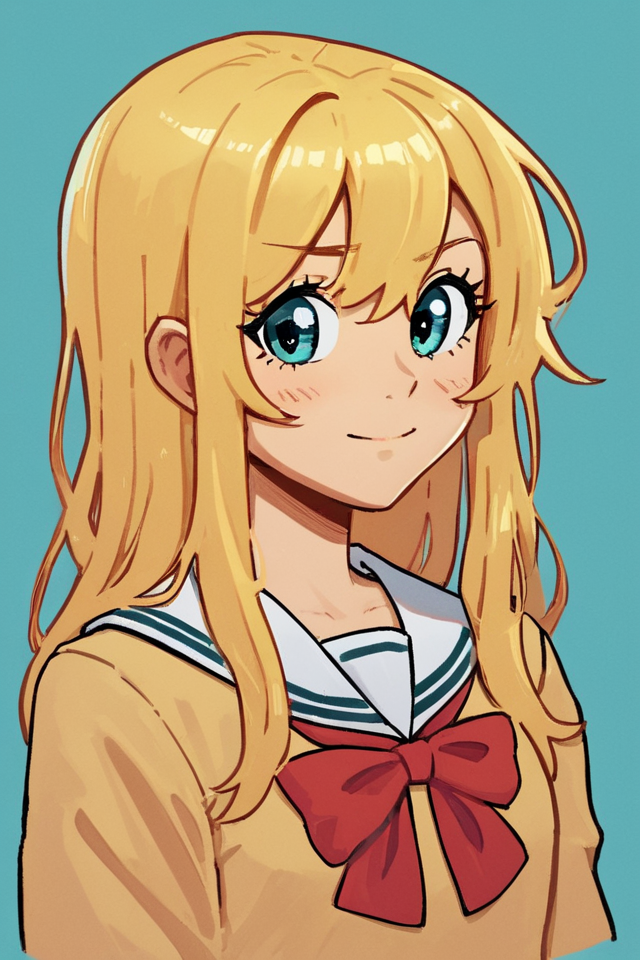
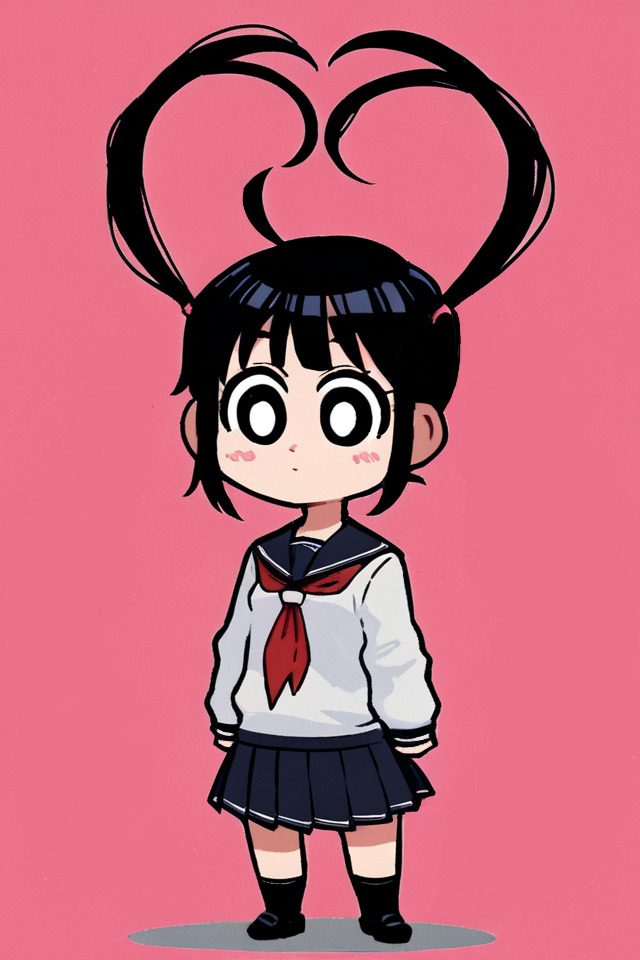
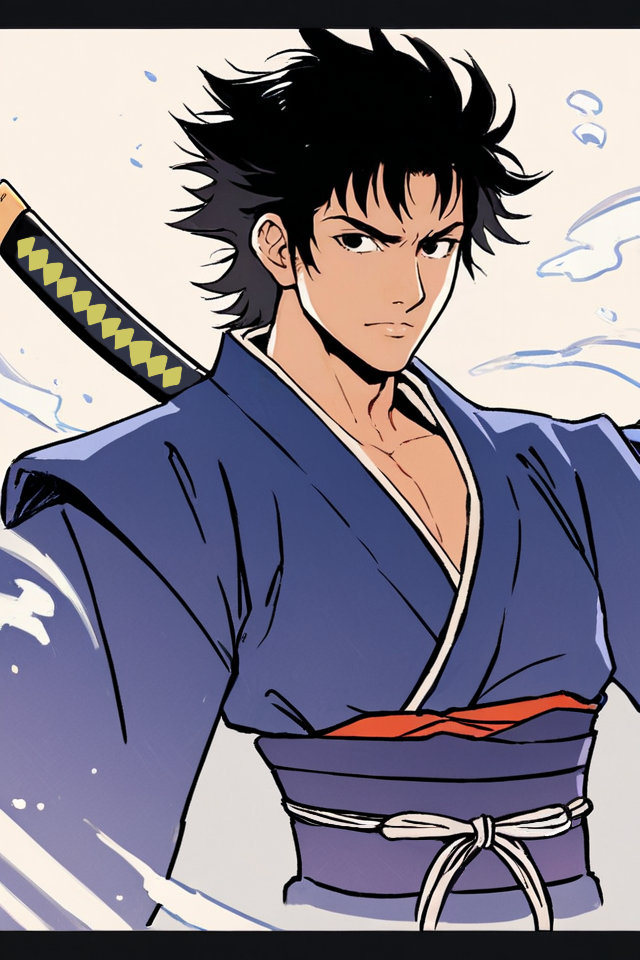
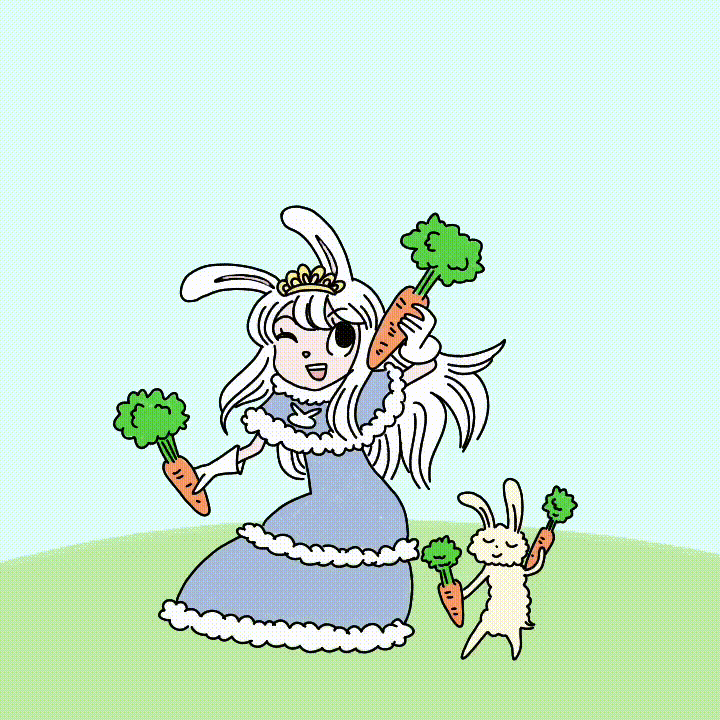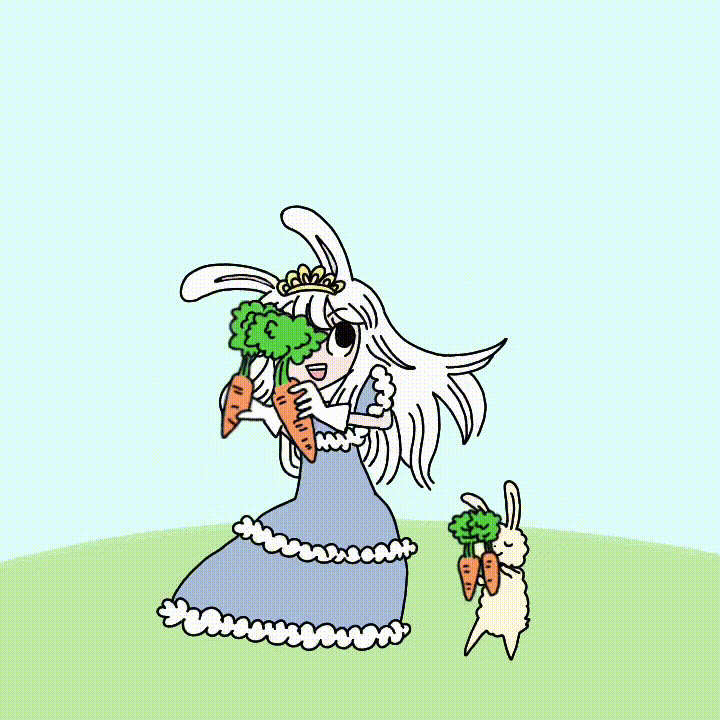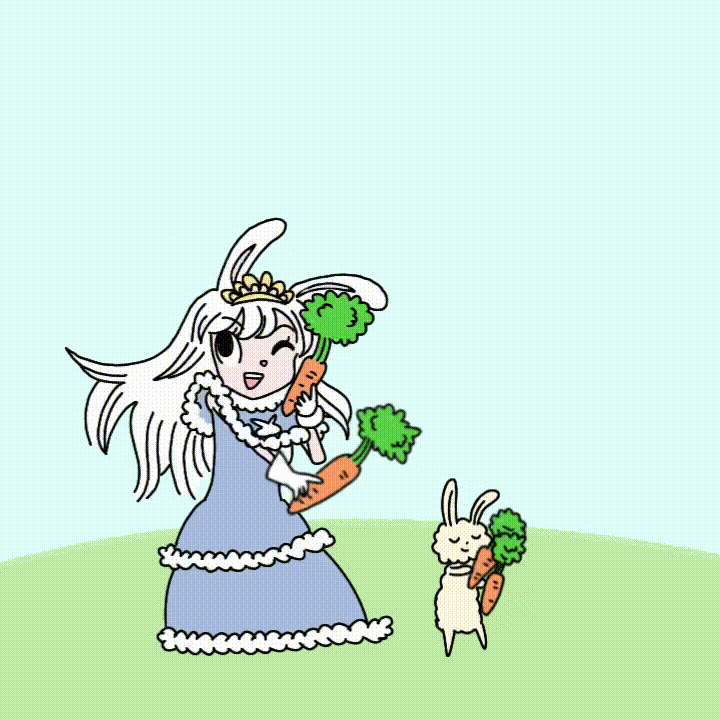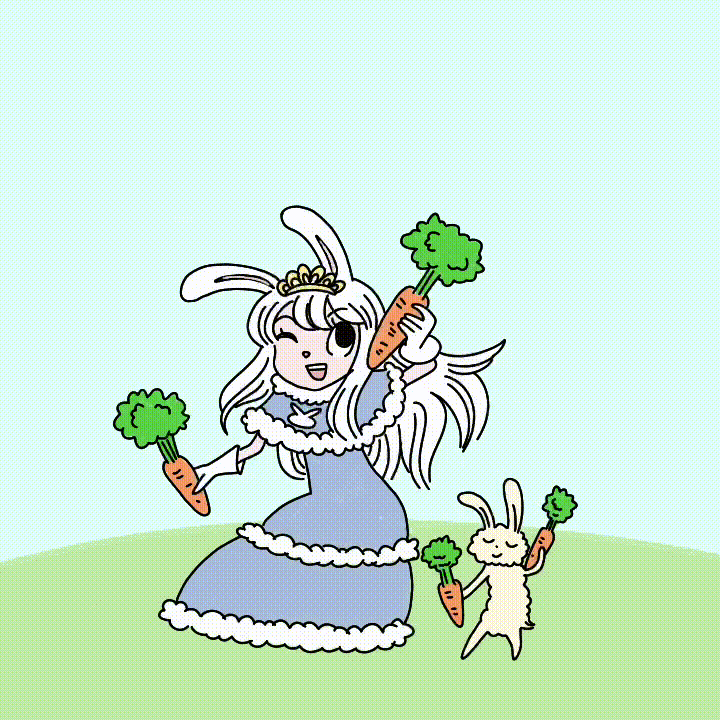
以下のイラストは作品の一部になります。
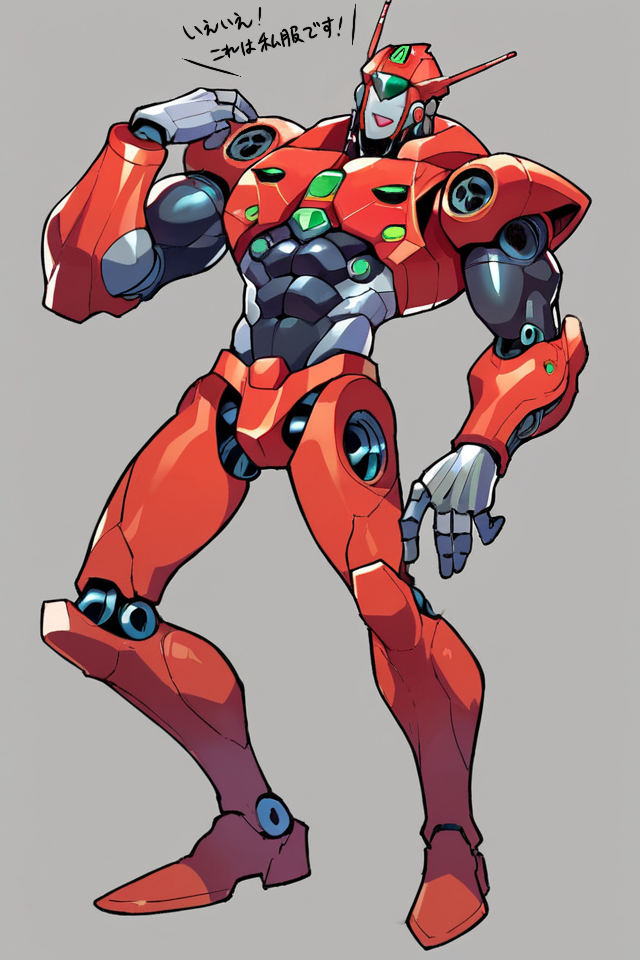
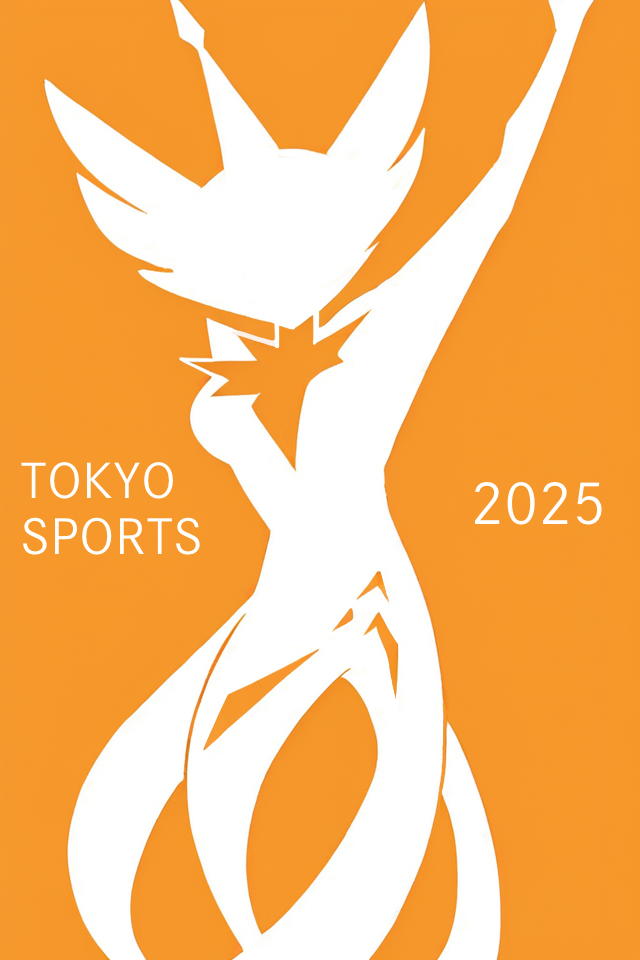
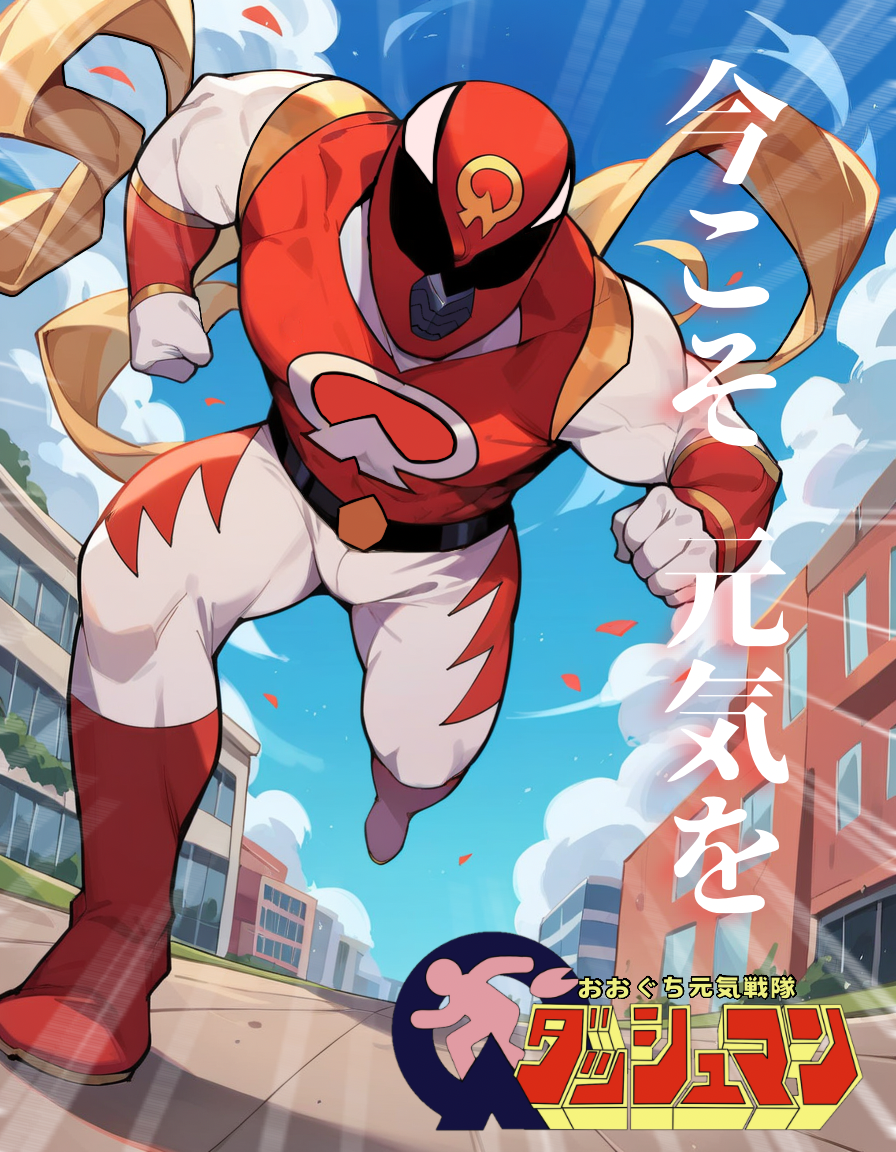
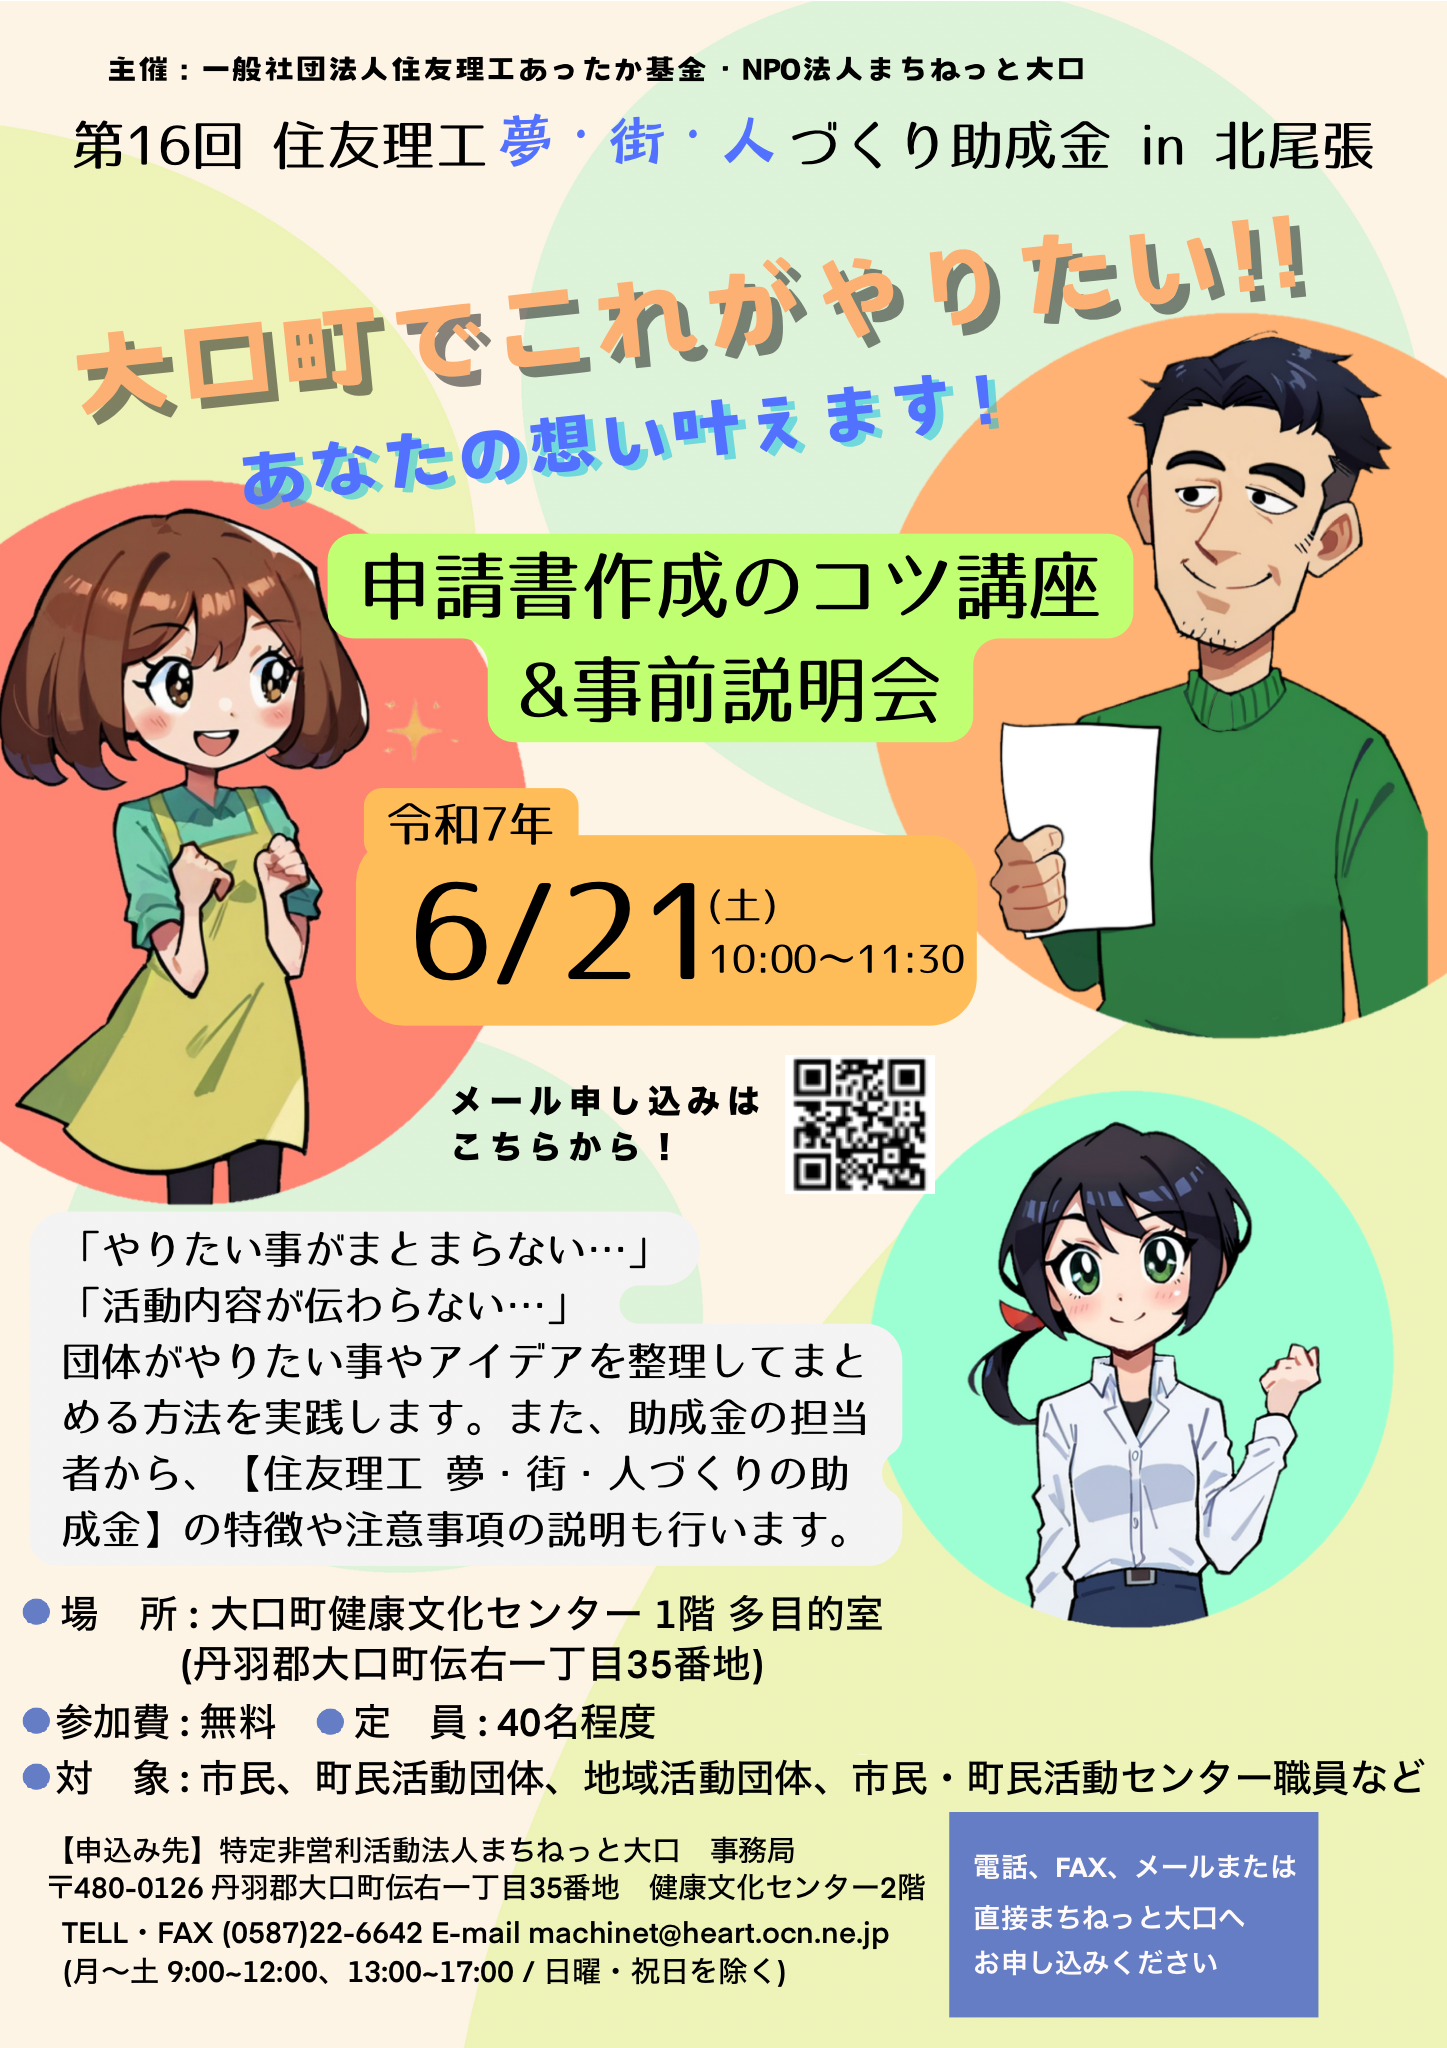
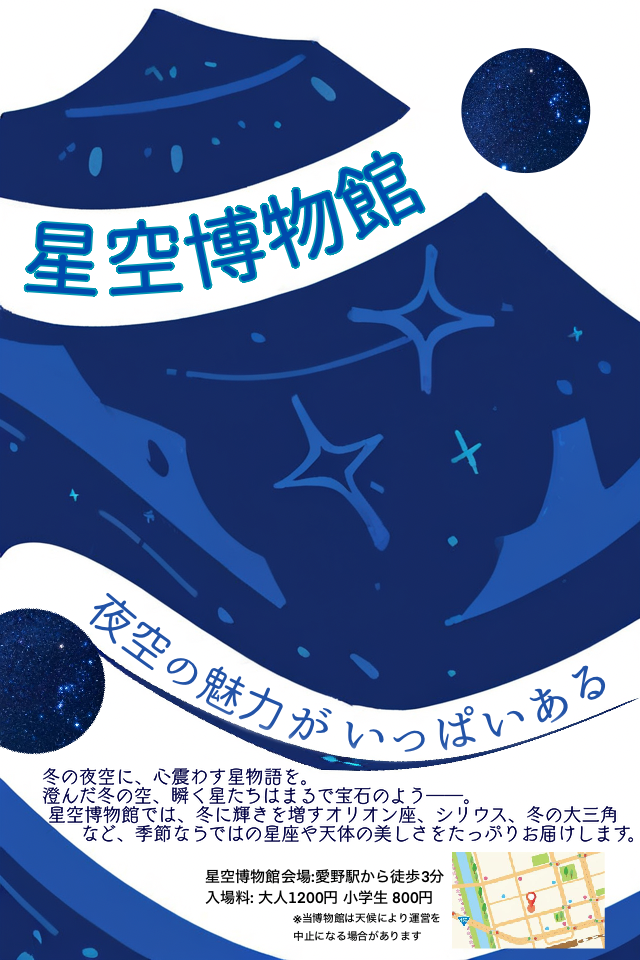
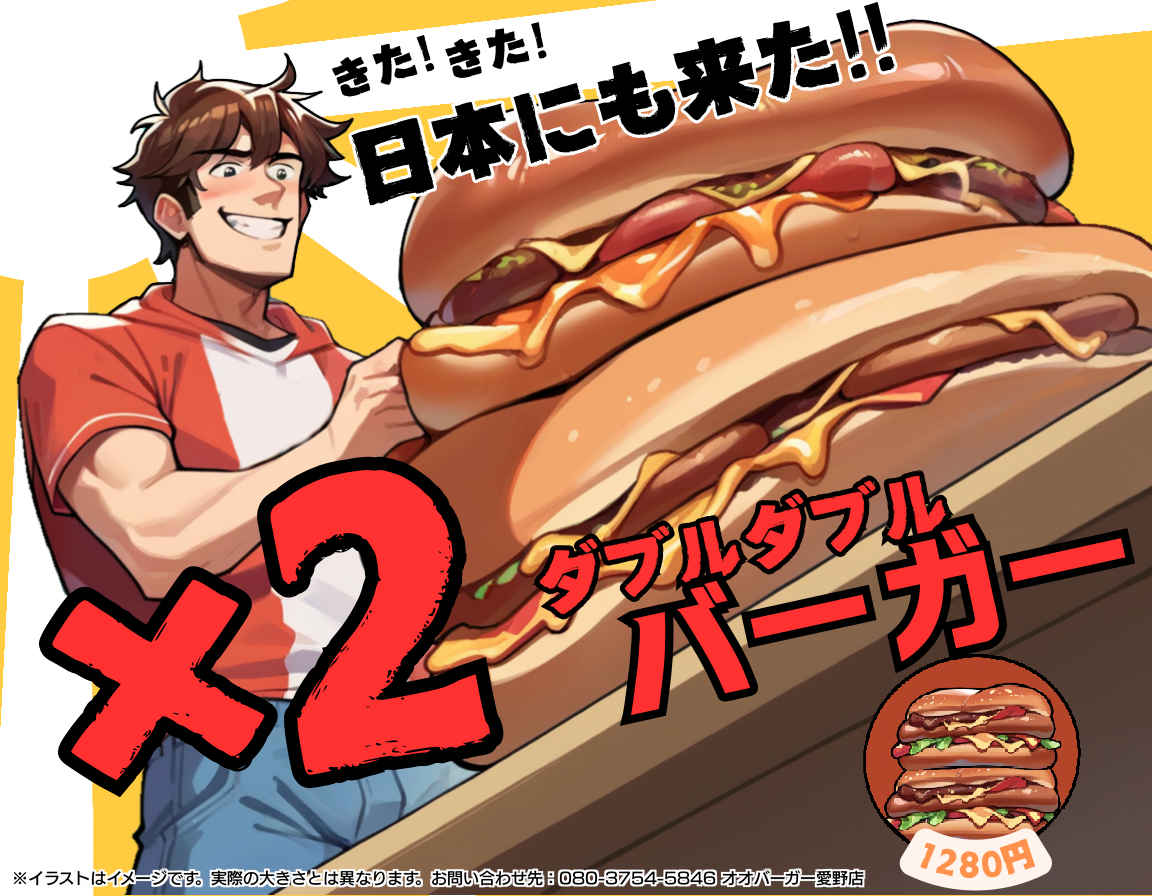
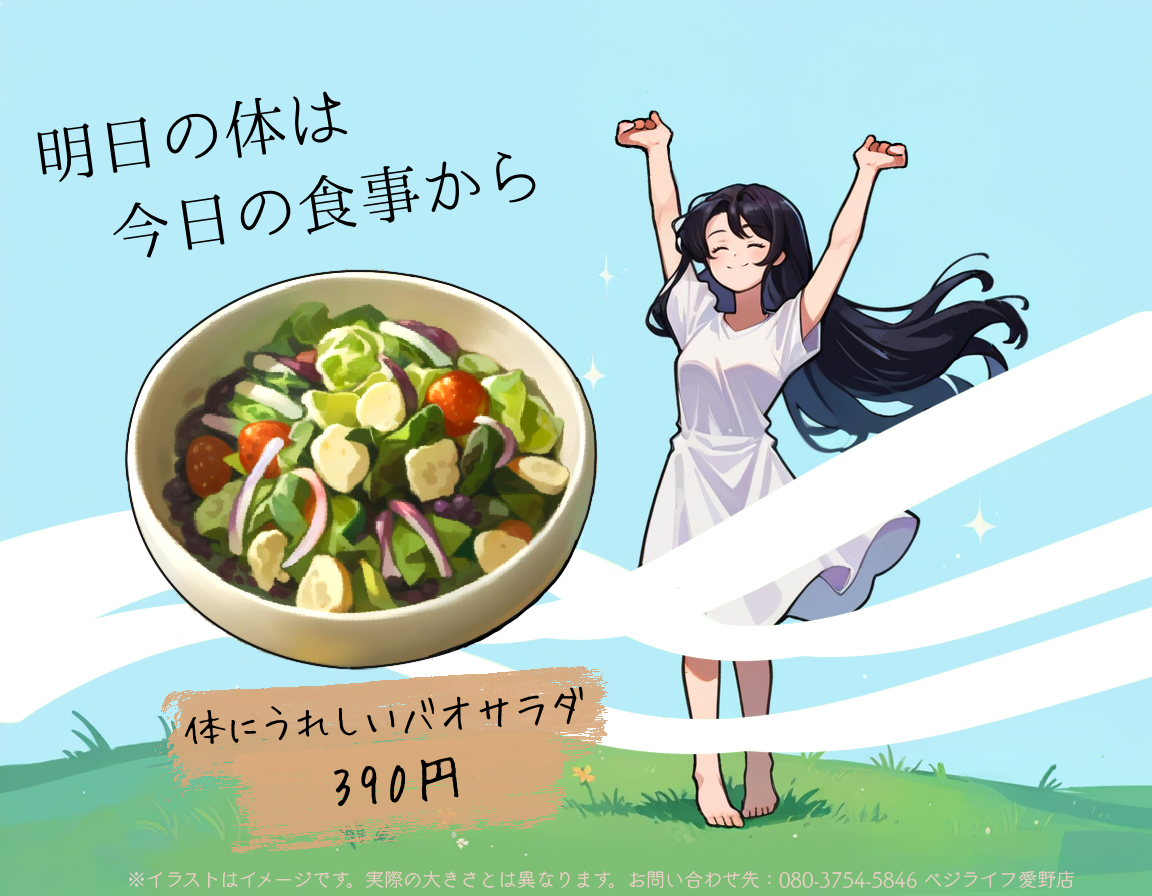
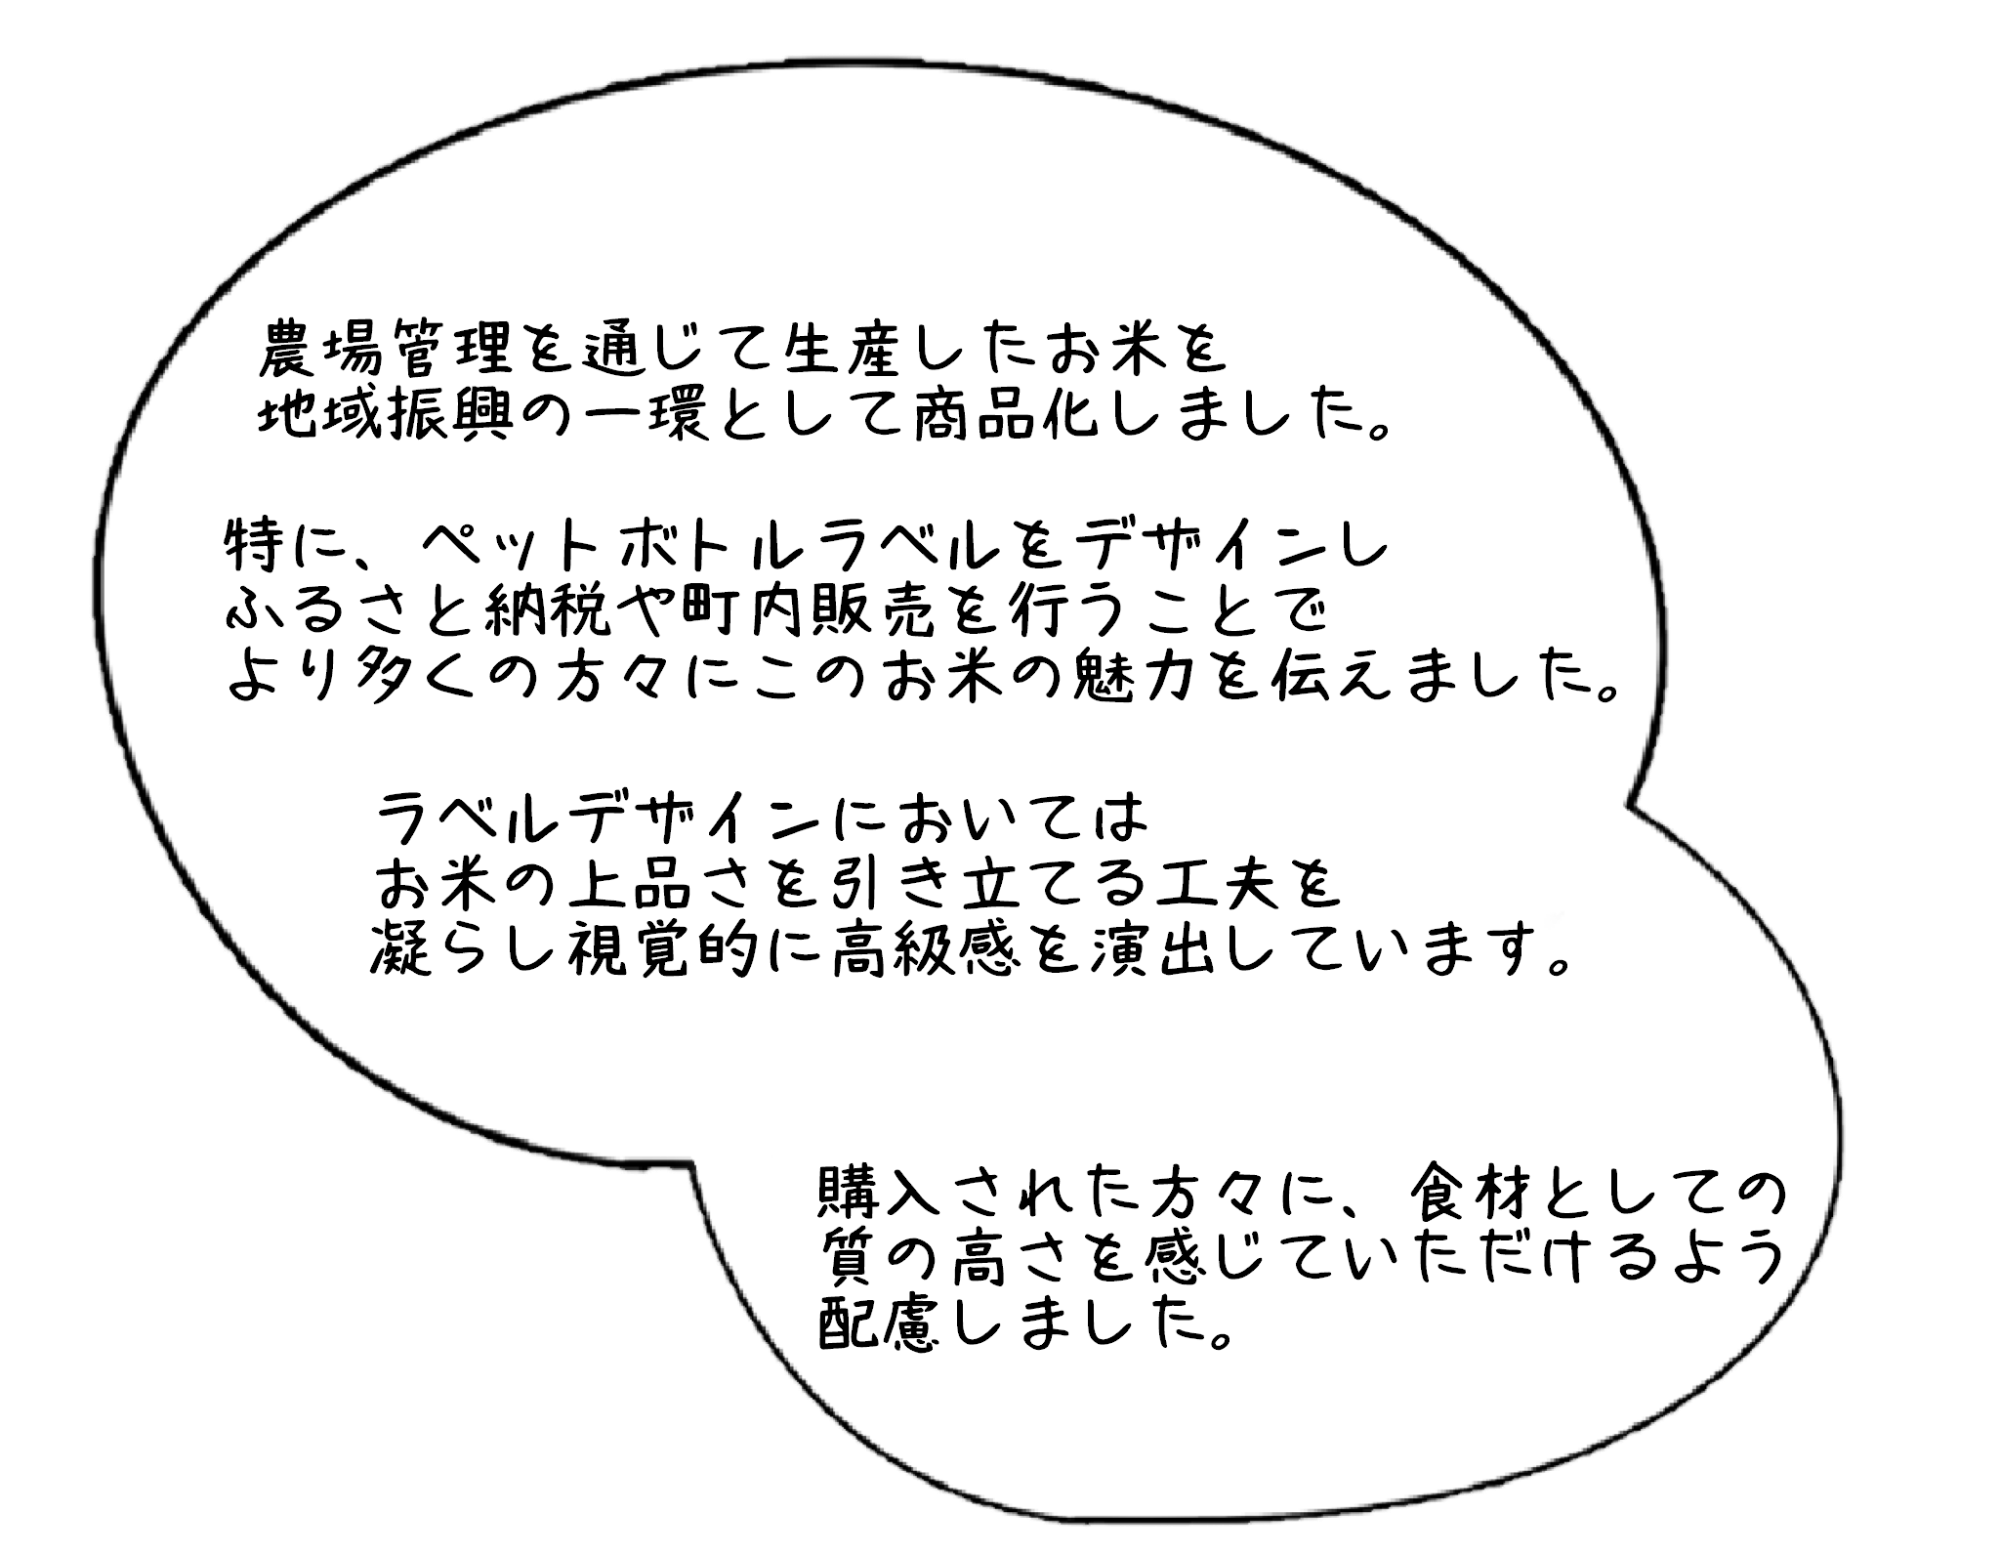
映像作品の例
ポートフォリオは以上となります。ご覧いただきまして、ありがとうございます。
創作活動では探求心を持ち、学ぶ意欲と身に着けた技術を活かしていきたいと考えております。興味を持っていただけましたら幸いです。
何卒よろしくお願いいたします。
このページはWepageで作成されています。今すぐ無料でホームページを作ってみませんか?
Wepageは、HTMLの知識がなくても、誰でも簡単にホームページを作成できます。詳しくはこちら